Comment les véhicules autonomes apprennent-ils à conduire ? L'école fantôme de la simulation
Partagez cette page
Les véhicules autonomes apprennent à conduire non pas sur de vraies routes, mais principalement en simulation : une intelligence artificielle qui essaie et se trompe des millions de fois dans un monde virtuel de milliards de kilomètres, combinée à des données de routes réelles, apprend à prendre des décisions dans le trafic quotidien. Mais savoir qu'un conducteur brillant en simulation n'affichera pas les mêmes performances sur l'asphalte est tout aussi important que d'apprendre. Voici toute l'histoire de cette tension fascinante.
Points clés
- Environ 11 milliards de miles de données de routes réelles sont nécessaires pour prouver une sécurité de niveau humain ; avec des tests physiques, cela représenterait des centaines d'années.
- Waymo, plus de 20 milliards de miles de conduite simulée ont été accumulés ; les miles réels en autonomie complète se situent autour de 200 millions .
- L'équipe McCity de l'Université du Michigan a calculé que le temps et le coût des tests avec des « mauvais conducteurs » virtuels pouvaient être réduits de 1000 fois .
- Un véhicule autonome produit environ 4 téraoctets de données par heure.
- Un comportement qui fonctionne parfaitement en simulation peut ne pas donner le même résultat dans le monde réel : c'est ce qu'on appelle le fossé sim-to-real.
Comment les véhicules autonomes apprennent-ils à conduire en simulation ?
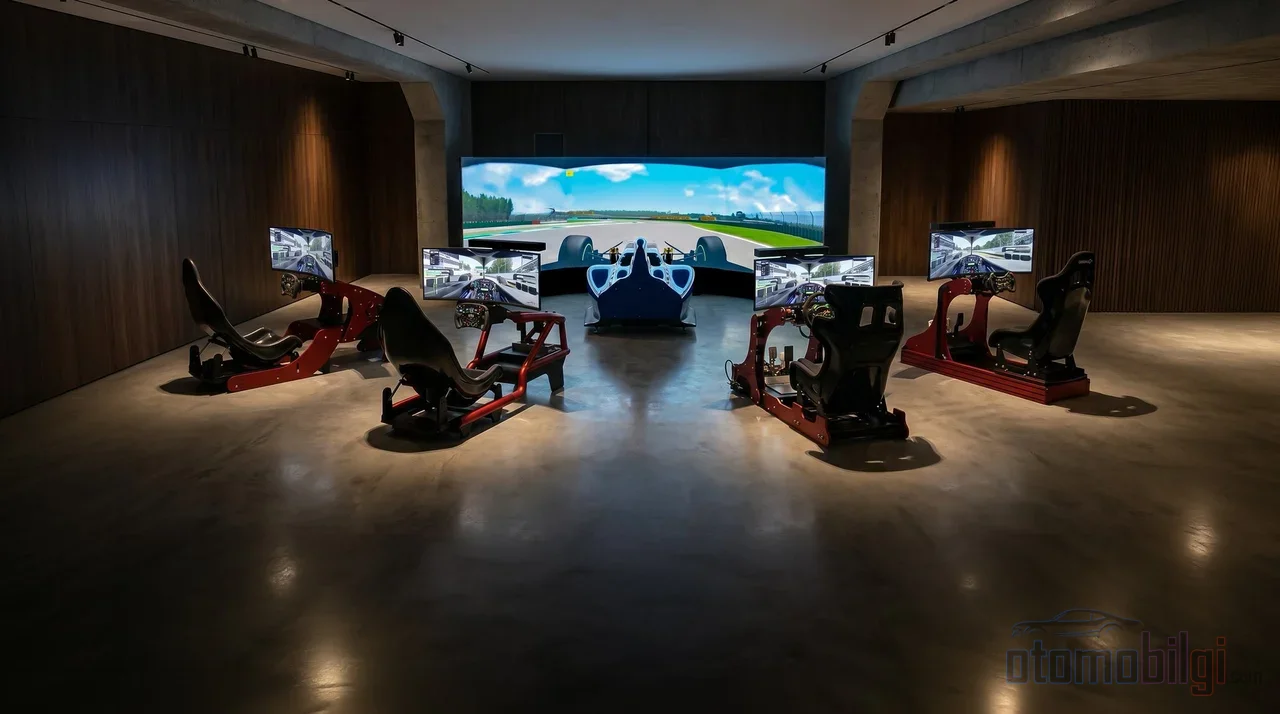
Les humains apprennent à conduire sur la route ; l'intelligence artificielle, elle, apprend surtout à l'intérieur d'un ordinateur. Les systèmes de conduite autonome ne fonctionnent pas sur la base de règles, mais avec des modèles probabilistes qui apprennent à partir des données. Autrement dit, un ingénieur n'écrit pas de code disant « agis ainsi à une intersection » ; le système observe des millions d'exemples et apprend le comportement lui-même. Une partie importante de ces exemples provient de la simulation.
Le processus fonctionne grosso modo ainsi :
- Collecte de données réelles : Les véhicules de test circulent sur les routes en enregistrant des données de caméra, de radar et de lidar ; ces données, qui produisent environ 4 téraoctets par heure, atteignent un volume de pétaoctets en moins d'une semaine.
- Les données sont transformées en monde virtuel : Les techniques de reconstruction neuronale convertissent de véritables enregistrements de conduite multisenseurs en environnements 3D haute fidélité. Les modèles de monde génératifs ajoutent des variations de météo, de lumière et de scénarios rares.
- L'intelligence artificielle est entraînée par essais et erreurs : Grâce à l'apprentissage par renforcement, le système essaie des comportements comme changer de voie, dépasser et céder le passage de nombreuses fois dans un trafic virtuel ; les comportements donnant de bons résultats sont récompensés.
- Tests de sécurité : Avant d'être utilisées sur de vraies routes, les politiques passent par des tests progressifs tels que software-in-the-loop (SIL), hardware-in-the-loop (HIL) et vehicle-in-the-loop (VIL).
Alors, qu'apprend réellement l'intelligence artificielle ? Pour la reconnaissance d'objets, ce sont les réseaux de neurones convolutifs (CNN) ; pour prédire les mouvements des autres véhicules et piétons 3 à 5 secondes à l'avance, les Transformers ; et pour les interactions aux intersections, les réseaux de neurones en graphe qui se démarquent. Certains systèmes utilisent des architectures de bout en bout qui apprennent directement le volant et le freinage à partir des données brutes des capteurs - mais celles-ci sont encore considérées comme expérimentales en raison de problèmes de certification.
Le problème des 11 milliards de miles : pourquoi la simulation est-elle indispensable ?
Voici la mathématique impitoyable de l'affaire. Pour atteindre un taux d'erreur de niveau humain, les véhicules autonomes ont besoin d'environ 11 milliards de miles il doit le faire. Accomplir cela par des tests physiques prendrait des siècles - autrement dit, personne ne peut attendre. C'est pourquoi le secteur n'a d'autre choix que la simulation : la plus grande partie de la preuve de sécurité ne peut être produite que dans le monde virtuel. Si l'on ajoute que le marché des simulateurs de formation de conduite vaut déjà 2,2 milliards de dollars en 2026 et devrait atteindre 3,0 milliards de dollars d'ici 2033, ce n'est pas une mode, c'est l'infrastructure fondamentale de l'industrie.
Les superpouvoirs du monde virtuel
Le plus grand avantage de la simulation, c'est de pouvoir tester encore et encore des choses impossibles dans le monde réel. Un piéton surgissant brusquement sur la route, un véhicule qui freine brusquement, des phares éteints dans la nuit noire, un brouillard dense, un éblouissement par le soleil... Tout cela peut être testé dans un environnement virtuel en toute sécurité et de manière répétable dans des conditions identiques. Même les défaillances de capteurs peuvent être simulées : scénariser une défaillance de la caméra frontale sur une vraie route est à la fois dangereux et coûteux ; dans le virtuel, il suffit de quelques clics.
Le travail de McCity montre ici une manœuvre astucieuse : un environnement de test virtuel constitué de mauvais conducteurs simulés brise la "malédiction de la rareté" pour développer la capacité de prise de décision en situation d'urgence. Un scénario que vous rencontreriez une fois par an dans la réalité, vous pouvez le vivre mille fois par jour dans le monde virtuel. En outre, dans certains cas d'usage, la validation de sécurité ne peut être réalisée que par simulation - autrement dit, même le processus officiel de certification dépend désormais du monde virtuel.
Tesla et Waymo : deux écoles différentes, la même leçon ?
Les deux pionniers du secteur enseignent la conduite de deux manières différentes. Résumons la différence dans un tableau :
| Caractéristique | Tesla FSD | Waymo |
|---|---|---|
| Approche des capteurs | Caméra uniquement (vision-only) | Caméra + lidar + radar imageur |
| Architecture | De bout en bout, toute la perception dans une seule architecture | Perception multisenseurs + cartes très détaillées |
| Source de données | Flotte de clients de millions de véhicules | Flotte de test + simulation massive |
| Kilomètres de simulation | - | Plus de 20 milliards de miles virtuels |
| Situation actuelle | FSD (Supervised) : sous la supervision du conducteur | Environ 200 millions de miles entièrement autonomes |
La stratégie de Tesla est audacieuse : elle met de côté le lidar et l'infrastructure cartographique et confie tout à une seule architecture qui apprend à partir des données de caméra. Son avantage, c'est l'échelle - chaque Tesla sur la route est un enseignant. Waymo, elle, travaille avec des données de capteurs plus riches et souligne que, même pour elle, cela ne suffit pas à soi seul, quelle que soit la quantité de simulation ou de conducteurs d'essai. Le plus intéressant : l'idée que les deux approches sont plus semblables qu'on ne le pense est également forte. Car Waymo aussi apprend, par un entraînement piloté par les données, la meilleure façon de représenter chaque objet. La différence réside dans la richesse des données qui alimentent la perception.
Le pas du modèle du monde de Waymo
En février 2026, Waymo a annoncé un nouveau modèle du monde pour la simulation de conduite autonome. La société compte environ 200 millions de miles entièrement autonomes et des milliards de kilomètres virtuels sont désormais utilisés comme matière première pour produire des mondes virtuels plus réalistes. La chronologie est aussi impressionnante : en 2016, il y avait 2,5 milliards de kilomètres simulés, en 2018 on a dépassé les 6 milliards, en 2020 les 15 milliards ont été franchis, et aujourd'hui nous sommes au-dessus de 20 milliards. Même un simple feu jaune clignotant peut se transformer en milliers d'heures d'expérience virtuelle.
Le fossé sim-to-real : pourquoi un pilote brillant en simulation trébuche-t-il sur la route ?
Voici le coeur de l'article. Pourquoi un comportement parfaitement fonctionnel en simulation peut-il ne pas donner le même résultat dans le monde réel ? Ce différend porte un nom : sim-to-real gap - le fossé simulation-réalité. Les causes se regroupent en quatre catégories :
- Écart du domaine visuel : Les graphismes virtuels ne peuvent pas reproduire fidèlement la lumière réelle, les textures et le reflet brillant de l'asphalt chauffé par le soleil d'été.
- Erreur d'approximation physique : Le moteur physique du simulateur calcule approximativement la dynamique complexe du monde réel.
- Incompatibilité du bruit des capteurs : Les données réelles de lidar et de radar contiennent un bruit sale, retardé et difficile à prédire.
- Manque de scénarios à longue traîne : Toutes les bizarreries du monde réel ne peuvent pas être intégrées à la bibliothèque virtuelle.
Les recherches actuelles issues du monde de la robotique examinent précisément cela : des effets non modélisés, des retards de capteurs et des paramètres erronés peuvent faire échouer sur le terrain une étoile du laboratoire. Deux techniques se détachent comme solutions : domain randomization (dans le monde virtuel, on modifie aléatoirement la lumière, les couleurs et la physique pour rendre le système résistant à chaque variation rencontrée) et system identification (calibrer les paramètres du simulateur avec des données mesurées dans le monde réel). Le trafic en a fourni des exemples douloureux : en août 2023, Cruise, qui avait obtenu en Californie une licence de robotaxi payant, a causé en peu de temps deux graves accidents et sa flotte a été réduite de moitié. Un système qui semble sûr en simulation a été immédiatement recalé dans le monde réel.
Le déséquilibre des données et l'excès de confiance de l'intelligence artificielle
Le deuxième grand risque est moins visible : le déséquilibre des données d'entraînement. Ce problème, compté parmi les obstacles de la conduite autonome, repose sur une logique simple - les situations peu représentées dans le bassin de données sont des situations peu apprises par le système. La recherche du Georgia Tech a montré que cela pouvait se transformer en biais : en raison du biais algorithmique, il a été avancé que les véhicules autonomes pourraient mettre en danger certains groupes, par exemple les piétons à la peau foncée. Ce n'est pas un détail technique, c'est une alerte éthique.
Le troisième risque concerne le caractère de l'intelligence artificielle : les systèmes d'IA peuvent attribuer des scores de confiance élevés à des réponses erronées. Ils ne peuvent pas dire "je ne suis pas sûr" comme un humain ; leur assurance hérite même des biais cognitifs humains via les données d'entraînement, les hypothèses du modèle et les boucles de rétroaction. Dans la détection des cas extrêmes, les faux positifs entraînent des interventions inutiles, tandis que les faux négatives conduisent à manquer des événements critiques. De plus, les étiquettes synthétiques générées automatiquement ne sont pas toujours assez fiables pour un entraînement critique pour la sécurité. Selon un expert, il reste encore 10 ans avant des véhicules autonomes fiables - et dans un véhicule qui gère mal un cas extrême, la marge d'erreur est pratiquement nulle.
Quel est le prix d'une confiance excessive dans la simulation ?
À ce stade, deux camps s'affrontent. Les défenseurs ont raison : en raison de l'obstacle des 11 milliards de miles, une preuve de sécurité sans simulation est pratiquement impossible. Les sceptiques ont aussi raison : les tests basés sur la simulation contiennent-ils vraiment tous les scénarios du monde réel ? Cette question reste en suspens depuis des années. Même la propre déclaration de Waymo suggère que le volume de simulation ne suffit pas à lui seul. Et Steve Wozniak, figure connue du domaine, soutient que dans des situations inhabituelles, le volant doit passer entre les mains même de l'humain le plus stupide - un point sarcastique mais qui donne à réfléchir.
Une autre critique est que les méthodes actuelles de simulation de conduite ne peuvent pas produire de manière évolutive des scénarios de coin ciblés. Autrement dit, trouver "ce moment dangereux distinctif" reste en partie un travail humain. Les études partagées sur OpenReview cherchent une solution à ce problème de mise à l'échelle, mais il est difficile de dire qu'il est déjà résolu.
Les véhicules autonomes peuvent-ils apprendre entièrement en simulation puis prendre la route ?
Réponse courte : non, pas à eux seuls. La simulation est un terrain d'entraînement inestimable ; mais aucun système ne prend la route sans être nourri de données réelles et sans passer par des tests progressifs dans le monde réel. Même le système le plus compétent d'aujourd'hui n'est pas totalement autonome - le FSD de Tesla attend la surveillance du conducteur avec l'indication "Supervised", c'est-à-dire "sous supervision", au début de son nom. La simulation est l'école de l'ombre ; le diplôme, lui, se décerne sur la vraie route. La meilleure IA conductrice sera celle qui marie l'entraînement virtuel à l'expérience réelle de la route - et qui n'oublie jamais la différence entre les deux mondes.
Références
- Simulation et validation des véhicules autonomes
- 6 raisons d'utiliser un logiciel de simulation de véhicules autonomes
- L'apprentissage automatique dans les véhicules autonomes : entièrement expliqué
- Le modèle mondial de Waymo
- Technologie de conduite autonome pour un trajet fiable
- Qu'est-ce que l'écart simulation-réalité ?
- Des mauvais conducteurs simulés réduisent le temps et le coût des tests de véhicules autonomes
- Tesla vs Waymo - Qui est le plus proche du niveau 5 d'autonomie ?
- Les systèmes de conduite autonome de Waymo et Tesla sont plus similaires que vous ne le pensez
- Cas limites en conduite autonome : détection et gestion
- La recherche révèle les conséquences potentiellement fatales des biais algorithmiques
- Conduite entièrement autonome (supervisée)