自动驾驶汽车是如何学会驾驶的?模拟的“影子学校”
分享此页面
自动驾驶汽车主要不是在真实道路上,而是在大规模仿真中学习驾驶:在数十亿公里的虚拟世界里,一个人工智能数百万次地试错,当它与真实道路数据结合后,便学会在日常交通中做出决策.但明白一个在虚拟环境中表现出色的驾驶者在真实柏油路上未必能有同样表现,这一点与学习本身同样重要.这正是那段耐人寻味的张力的全部故事.
要点速览
- 要达到人类水平的安全证明,大约需要 110亿英里 的真实道路数据;用物理测试来实现,意味着数百年时间.
- Waymo 已积累了超过200亿英里的 仿真驾驶里程;而真实的完全自动驾驶英里数则约为 2亿 英里.
- 密歇根大学的McCity团队计算出,用虚拟“恶劣驾驶者”进行测试,可将测试时间和成本 降低1000倍 .
- 一辆自动驾驶汽车每小时产生约 4太字节 的数据.
- 在仿真中运行完美的行为,在现实世界中未必带来同样结果:这被称为sim-to-real鸿沟.
自动驾驶汽车是如何在仿真中学习驾驶的?
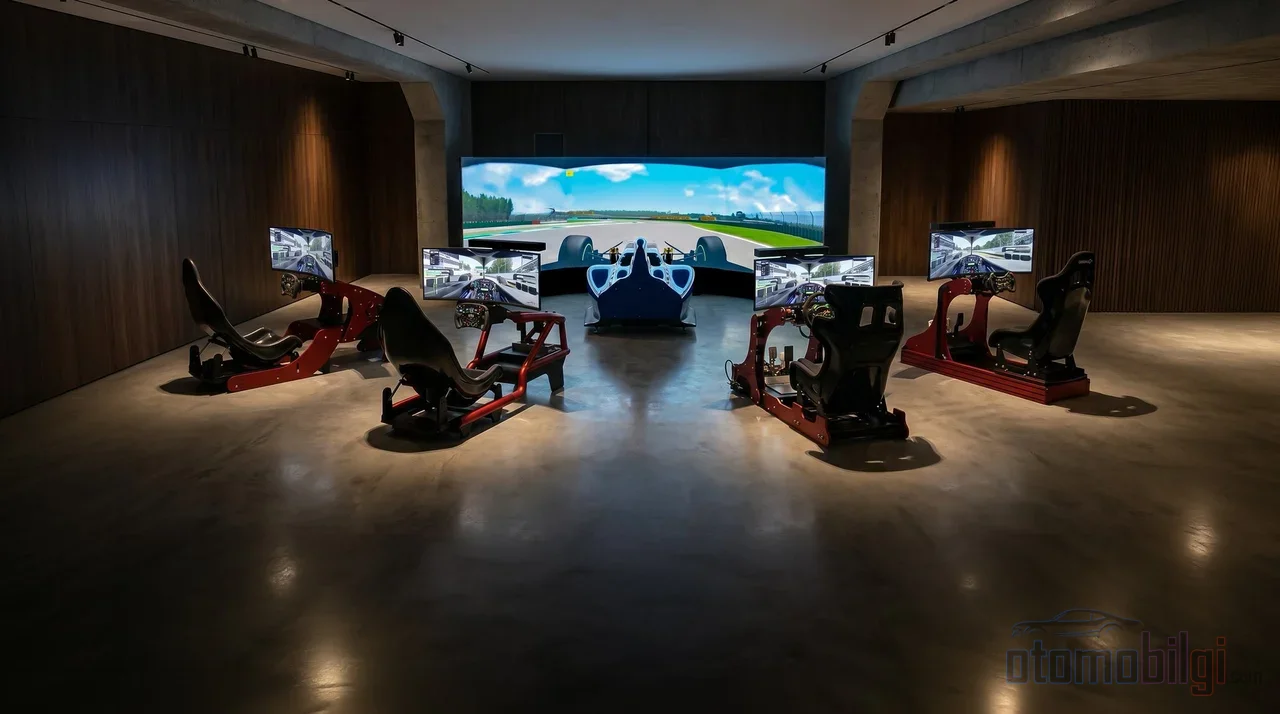
人类在路上学开车;而人工智能大多在计算机内部学习.自动驾驶系统并非基于规则,而是采用从数据中学习的概率模型.也就是说,工程师不会编写“在路口这样行驶”这样的代码;系统通过查看数百万个例子自行学习行为.这些例子的很大一部分来自仿真.
流程大致如下:
- 收集真实数据: 测试车辆在道路上行驶时记录摄像头、雷达和激光雷达数据;而且这些每小时产生约4太字节的数据,在一周之内就能积累到PB级别.
- 将数据转化为虚拟世界: 神经重建技术将真实的多传感器驾驶记录转换为高保真3D环境.生成式世界模型还会加入天气、光照和罕见场景的变化.
- 人工智能通过试错进行训练: 借助强化学习,系统在虚拟交通中反复尝试变道、超车和让行等行为;取得良好结果的行为会得到奖励.
- 进行安全测试: 在真实道路上启用之前,策略需要通过软件在环(SIL)、硬件在环(HIL)和实车在环(VIL)等分级测试.
那么人工智能到底学到了什么?在物体识别方面,卷积神经网络(CNN)表现突出;在预测其他车辆和行人3至5秒后的动作方面,Transformer占优势;而在路口交互方面,图神经网络则更为出色.还有一些系统采用从原始传感器数据直接学习转向和制动的端到端架构——但由于认证问题,这些架构仍被视为实验性的.
110亿英里难题:为什么仿真不可或缺?
这里面的数学运算十分残酷.要达到人类水平的错误率,自动驾驶汽车大约需要行驶 110亿英里 据计算,这是需要完成的工作.用物理测试来完成需要数百年——也就是说没人等得起.因此行业别无选择只能依靠仿真:大部分安全证明只能在虚拟世界中产生.如果再加上驾驶员训练模拟器市场在2026年已达22亿美元,并预计到2033年将增长至30亿美元,这就不是一时的潮流,而是行业的基础设施.
虚拟世界的超级能力
仿真最大的优势在于,可以反复尝试在现实世界中不可能实现的情况.突然冲入车道的行人、突然刹车的车辆、夜间熄灭的车灯、浓雾、阳光眩光……所有这些都可以在虚拟环境中安全地、在相同条件下重复测试.甚至传感器故障也能模拟:要在真实道路上构建一个前摄像头失灵的场景既危险又昂贵;而在虚拟环境中只需点击几下.
McCity的工作展示了其中的巧妙之处:用模拟的 坏驾驶员 构建的虚拟测试环境,打破了提升紧急决策能力的“稀有性诅咒”.一个现实中每年只会遇到一次的场景,在虚拟世界里你每天可以经历上千次.此外,在某些应用领域,安全验证只能通过仿真完成——也就是说,连官方认证流程也已依赖虚拟世界.
Tesla和Waymo:两个不同的流派,同一个课堂吗?
行业两大先驱以两种不同的方式教汽车驾驶.让我们用表格总结差异:
| 特性 | Tesla FSD | Waymo |
|---|---|---|
| 传感器方案 | 仅摄像头(vision-only) | 摄像头 + 激光雷达 + 成像雷达 |
| 架构 | 端到端,所有感知集中在单一架构 | 多传感器感知 + 高精度地图 |
| 数据来源 | 数百万辆车的客户车队 | 测试车队 + 海量仿真 |
| 仿真里程 | - | 超过200亿虚拟英里 |
| 当前状态 | FSD(Supervised):驾驶员监督下 | 约2亿英里完全自动驾驶里程 |
Tesla的策略大胆:弃用激光雷达和地图基础设施,将一切都托付给仅凭摄像头数据学习的单一架构.其优势在于规模——路上的每一辆Tesla都是一位老师.Waymo则使用更丰富的传感器数据工作,并强调无论拥有多少仿真或测试驾驶员,这些单独来看都不够.有趣的是,也有人强烈认为这两种方法比想象中更为相似.因为Waymo也是通过数据驱动的训练来学习表示每个物体的最佳方式.差别在于进入感知系统的数据的丰富程度.
Waymo的世界模型之步
2026年2月,Waymo发布了一款用于自动驾驶仿真的新世界模型.该公司的约 2亿英里完全自动驾驶里程 以及数十亿虚拟英里,如今正被用作生产更逼真虚拟世界的原材料.时间线同样令人印象深刻:2016年有25亿模拟英里,2018年突破60亿,2020年超过150亿,如今已达200亿以上.哪怕只是一个闪烁的黄灯,也能转化为数千小时的虚拟经验.
仿真到现实的鸿沟:为什么在虚拟中表现优异的车手在真实道路上会踉跄?
这正是文章的核心.在仿真中运行完美的行为,为什么在现实世界中未必产生同样的结果?这种差异被称为 sim-to-real gap - 仿真与现实之间的鸿沟.其原因可归纳为四个方面:
- 视觉领域差异: 虚拟图形无法完全复制真实的光线、纹理以及夏日高温下沥青路面的反光.
- 物理近似误差: 仿真器的物理引擎只能近似计算现实世界的复杂动力学.
- 传感器噪声不匹配: 真实的激光雷达和雷达数据带有噪声大、延迟高且难以预测的干扰.
- 长尾场景缺失: 现实世界中的所有异常情况都无法全部录入虚拟数据库.
来自机器人领域的最新研究恰恰在探究这一点:未建模的效应、传感器延迟和错误参数,都可能让实验室里的明星在实地遭遇失败.目前有两种备受关注的解决技术: domain randomization (在虚拟世界中随机改变光线、颜色和物理特性,使系统能够应对所遇到的每一种变化)和 system identification (利用从现实世界测量到的数据校准仿真器的参数).交通领域已发生过惨痛的实例:2023年8月,在加利福尼亚州获得收费机器人出租车运营许可的Cruise,短时间内发生了两起严重事故,其车队规模被削减了一半.在仿真中看似安全的系统,在现实世界中却立刻败下阵来.
数据不均衡与人工智能的过度自信
第二大风险不那么显眼:训练数据的不均衡.作为自动驾驶的障碍之一,这个问题基于一个简单的逻辑——在数据池中代表性不足的情况,就意味着系统中学习不足的情况.佐治亚理工学院的研究表明,这可能转化为偏见:有人提出,由于算法偏见,自动驾驶车辆可能危及特定群体,例如深色皮肤的行人.这不仅是技术细节,更是一记道德警钟.
第三个风险与人工智能的特性有关:人工智能系统可能会给错误答案赋予很高的置信度分数.它无法像人类那样说"我不确定";其自信心甚至会通过训练数据、模型假设和反馈循环继承人类的认知偏见.在边缘情况检测中,假阳性会导致不必要的干预,而假阴性则会造成关键事件的遗漏.更何况,自动生成的合成标签对于安全关键的训练而言并不总是足够可靠.一位专家认为,可靠的自动驾驶汽车距离我们还有 10 年之久 - 而在一辆错误处置边缘情况的车辆上,容错空间实际上为零.
过度信任模拟的代价是什么?
在这一点上,两个阵营针锋相对.支持者有理:由于 110 亿英里门槛的存在,没有模拟的安全证明实际上是不可能的.怀疑者也有理:基于模拟的测试真的涵盖了现实世界中的所有场景吗?这个问题多年来悬而未决.就连 Waymo 自己的声明也暗示,单靠模拟量是不够的.而该领域的知名人士 Steve Wozniak 则主张,在异常情况下,方向盘必须交到哪怕是最笨的人手中 - 这是一个讽刺却发人深省的观点.
另一项批评是,现有的驾驶模拟方法无法以可扩展的方式生成有针对性的极端场景.也就是说,找到"那个特定的危险时刻"在很大程度上仍然是人工工作.在 OpenReview 上发表的研究正在寻求解决这一扩展问题的方案,但很难说已经完成.
自动驾驶汽车能否完全在模拟中学习后上路?
简短的回答:不能,单靠模拟不行.模拟是无价的训练场;但任何系统如果不经真实道路数据喂养、不经过分阶段的现实世界测试,都无法上路.即使是当今最有能力的系统也并非完全自动驾驶 - Tesla 的 FSD 在名字开头带有 "Supervised" 即"受监督"的标识,等待着驾驶员的接管.模拟是影子学校;而文凭要在真实道路上颁发.最优秀的驾驶人工智能将是把虚拟训练与真实道路经验相融合的那种 - 并且永远不忘两个世界之间的差距.