Jak autonomiczne pojazdy uczą się jazdy? Podręczna szkoła symulacji
Udostępnij tę stronę
Pojazdy autonomiczne uczą się jazdy nie na prawdziwych drogach, lecz w dużej mierze w symulacji: miliardy kilometrów wirtualnego świata, w których sztuczna inteligencja miliony razy próbuje i popełnia błędy, w połączeniu z danymi z prawdziwych dróg pozwala jej uczyć się podejmowania decyzji w codziennym ruchu. Ale świadomość, że kierowca błyszczący w symulacji nie pokaże tej samej wydajności na asfalcie, jest równie ważna jak samo uczenie się. Oto cała historia tego intrygującego napięcia.
Najważniejsze informacje
- Dla dowodu bezpieczeństwa na poziomie ludzkim potrzeba około 11 miliardów mil danych z prawdziwych dróg; w ramach testów fizycznych oznacza to setki lat.
- Waymo zgromadził ponad 20 miliardów mil symulowanej jazdy; natomiast rzeczywiste, w pełni autonomiczne mile sięgają około 200 milionów.
- Zespół McCity Uniwersytetu Michigan obliczył, że czas i koszty testów z wirtualnymi "złymi kierowcami" można zmniejszyć 1000 razy.
- Pojazd autonomiczny generuje około 4 terabajty danych na godzinę.
- Zachowanie idealnie działające w symulacji może nie dać tego samego rezultatu w rzeczywistości: nazywa się to luką sim-to-real.
Jak pojazdy autonomiczne uczą się jazdy w symulacji?
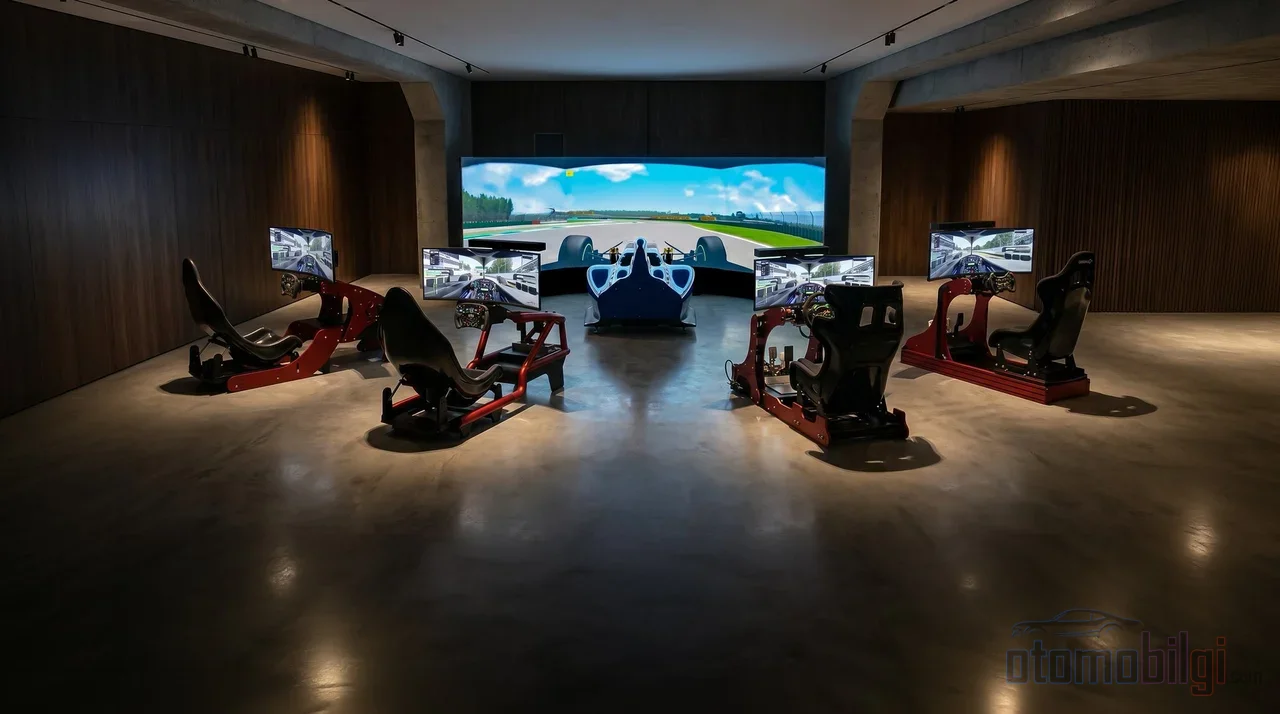
Ludzie uczą się jazdy samochodem na drodze; sztuczna inteligencja w większości wewnątrz komputera. Systemy jazdy autonomicznej nie działają w oparciu o reguły, lecz o modele probabilistyczne uczące się z danych. Oznacza to, że inżynier nie pisze kodu w stylu "na skrzyżowaniu zachowaj się tak"; system sam uczy się zachowania, analizując miliony przykładów. Znaczna część tych przykładów pochodzi z symulacji.
Proces przebiega z grubsza następująco:
- Zbierane są prawdziwe dane: Pojazdy testowe krążące po drogach rejestrują dane z kamer, radarów i lidarów; dodatkowo te dane, generujące około 4 terabajty na godzinę, w niecały tydzień osiągają skalę petabajtów.
- Dane przekształcane są w wirtualny świat: Techniki rekonstrukcji neuronowej przekształcają rzeczywiste nagrania jazdy z wielu czujników w środowiska 3D o wysokiej wierności. Generatywne modele świata dodają też wariacje pogody, światła i rzadkich scenariuszy.
- Sztuczna inteligencja jest trenowana metodą prób i błędów: Dzięki uczeniu ze wzmocnieniem system wielokrotnie próbuje zachowań takich jak zmiana pasa, wyprzedzanie i ustępowanie pierwszeństwa w wirtualnym ruchu; zachowania dające dobre rezultaty są nagradzane.
- Przeprowadzane są testy bezpieczeństwa: Zanim polityki trafią na prawdziwe drogi, przechodzą etapowane testy: software-in-the-loop (SIL), hardware-in-the-loop (HIL) oraz testy na prawdziwym pojeździe (VIL).
Czego więc naprawdę uczy się sztuczna inteligencja? W rozpoznawaniu obiektów przodują konwolucyjne sieci neuronowe (CNN), w przewidywaniu ruchu innych pojazdów i pieszych 3–5 sekund do przodu - Transformatory, a w interakcjach na skrzyżowaniach - grafowe sieci neuronowe. Niektóre systemy wykorzystują natomiast architektury end-to-end, uczące się bezpośrednio z surowych danych czujników sterowania i hamowania - ale ze względu na problemy z certyfikacją są one wciąż uznawane za eksperymentalne.
Problem 11 miliardów mil: Dlaczego symulacja jest konieczna?
Oto matematyka tej sprawy, która jest bezlitosna. Oblicza się, że aby osiągnąć wskaźnik błędów na poziomie ludzkim, pojazdy autonomiczne muszą przejechać około 11 miliardów mil. Zrealizowanie tego testami fizycznymi zajęłoby setki lat - czyli nikt nie może czekać. Dlatego branża jest zmuszona do symulacji: większość dowodów bezpieczeństwa można wytworzyć wyłącznie w świecie wirtualnym. Jeśli dodamy, że rynek symulatorów szkolenia kierowców jest wart już 2,2 miliarda dolarów w 2026 roku i oczekuje się wzrostu do 3,0 miliarda dolarów do 2033 roku, to nie jest to moda, lecz fundamentalna infrastruktura branży.
Supermoce świata wirtualnego
Największą zaletą symulacji jest możliwość wielokrotnego testowania rzeczy niemożliwych w świecie rzeczywistym. Pieszy nagle wchodzący na jezdnię, pojazd gwałtownie zmieniający pas, zgaszone światła w ciemności nocy, gęsta mgła, oślepiające słońce... Wszystko to jest bezpiecznie i w powtarzalnych warunkach testowane w środowisku wirtualnym. Nawet awarie czujników mogą być symulowane: stworzenie scenariusza z uszkodzoną przednią kamerą na prawdziwej drodze jest zarówno niebezpieczne, jak i kosztowne; w świecie wirtualnym to kilka kliknięć.
Praca MCity pokazuje tu sprytny zabieg: wirtualne środowisko testowe utworzone z symulowanymi złymi kierowcami łamie „klątwę rzadkości", aby rozwijać umiejętność podejmowania decyzji w sytuacjach awaryjnych. Scenariusz, z którym w rzeczywistości spotkałbyś się raz w roku, w świecie wirtualnym możesz przeżywać tysiąc razy dziennie. Dodatkowo w niektórych zastosowaniach walidację bezpieczeństwa można przeprowadzić wyłącznie symulacją - czyli nawet oficjalny proces certyfikacji jest już zależny od świata wirtualnego.
Tesla i Waymo: Dwie różne szkoły, ta sama lekcja?
Dwa pionierzy branży uczą jazdy na dwa różne sposoby. Podsumujmy różnicę w tabeli:
| Cecha | Tesla FSD | Waymo |
|---|---|---|
| Podejście sensorowe | Tylko kamera (vision-only) | Kamera + lidar + radar obrazujący |
| Architektura | End-to-end, cała percepcja w jednej architekturze | Percepcja wieloczujnikowa + szczegółowe mapy |
| Źródło danych | Flota klientów licząca miliony pojazdów | Flota testowa + gigantyczna symulacja |
| Kilometry symulacji | - | Ponad 20 miliardów wirtualnych mil |
| Obecny stan | FSD (Supervised): pod nadzorem kierowcy | ~200 milionów mil pełnej autonomiczności |
Strategia Tesli jest śmiała: wyłączając lidar i infrastrukturę map, wszystko powierza nauce z danych kamery. Zaletą jest to, że każdy Tesla jest nauczycielem. Waymo natomiast pracuje z bogatszymi danymi z czujników i podkreśla, że nawet jego zdaniem sama symulacja czy flota testowa nie wystarczy. Co ciekawe: silny jest też pogląd, że oba podejścia są bardziej podobne, niż się wydaje. Bo Waymo również uczy się najlepszego sposobu reprezentacji każdego obiektu poprzez trening oparty na danych. Różnica polega na bogactwie danych wchodzących do percepcji.
Krok Waymo: model świata
W lutym 2026 roku Waymo ogłosiło nowy model świata do symulacji jazdy autonomicznej. Zasoby firmy - 200 milionów mil pełnej autonomiczności i miliardy wirtualnych mil - są teraz wykorzystywane jako surowiec do tworzenia bardziej realistycznych wirtualnych światów. Chronologia jest imponująca: W 2016 roku było 2,5 miliarda symulowanych mil, w 2018 przekroczono 6 miliardów, w 2020 przekroczono 15 miliardów, a dziś jesteśmy powyżej 20 miliardów. Nawet pojedyncze migające żółte światło może zamienić się w tysiące godzin wirtualnego doświadczenia.
Przepaść sim-to-real: Dlaczego kierowca błyszczący w symulacji potyka się na drodze?
Tu właśnie znajduje się serce artykułu. Dlaczego zachowanie doskonale działające w symulacji może nie dać tego samego rezultatu w prawdziwym świecie? Ta różnica nazywa się sim-to-real gap - przepaścią między symulacją a rzeczywistością. Przyczyny grupuje się w cztery kategorie:
- Różnica w dziedzinie wizualnym: Wirtualna grafika nie potrafi wiernie odwzorować prawdziwego światła, faktury ani blasku asfaltu w upale letniego dnia.
- Błąd przybliżenia fizyki: Silnik fizyczny symulatora przybliża złożoną dynamikę rzeczywistego świata.
- Niezgodność szumu sensorów: Prawdziwe dane lidaru i radaru niosą zanieczyszczony, opóźniony i trudny do przewidzenia szum.
- Brak scenariuszy długiego ogona: Całej osobliwości prawdziwego świata nie da się zapisać w wirtualnej bibliotece.
Aktualne badania ze świata robotyki analizują dokładnie to: niezmodelowane efekty, opóźnienia sensorów i błędne parametry mogą doprowadzić laboratoryjną gwiazdę do porażki w terenie. Dwie techniki wyróżniają się jako rozwiązania: domain randomization (losowa zmiana światła, koloru i fizyki w świecie wirtualnym, dzięki czemu system staje się odporny na każdą napotkaną wariację) oraz system identification (kalibracja parametrów symulatora za pomocą danych zmierzonych w rzeczywistym świecie). W ruchu drogowym zdarzały się bolesne przykłady: W sierpniu 2023 Cruise, który otrzymał w Kalifornii pozwolenie na płatne robotaksi, w krótkim czasie miał dwie poważne wypadki, a jego flotę zmniejszono o połowę. System wydający się bezpieczny w symulacji natychmiast oblewał egzamin w rzeczywistym świecie.
Nierównowaga danych i nadmierna pewność siebie sztucznej inteligencji
Drugie wielkie ryzyko jest mniej widoczne: nierównowaga danych treningowych. Ten problem, wymieniany wśród przeszkód na drodze do autonomicznej jazdy, opiera się na prostej logice - stany słabo reprezentowane w puli danych to stany słabo wyuczone w systemie. Badanie Georgia Tech wykazało, że może to przeradzać się w uprzedzenie: wskazywano, że z powodu uprzedzenia algorytmicznego pojazdy autonomiczne mogą narażać określone grupy, na przykład pieszych o ciemnej karnacji skóry. To nie jest techniczny szczegół, lecz etyczny alarm.
Trzecie ryzyko dotyczy charakteru sztucznej inteligencji: Systemy sztucznej inteligencji potrafią przypisywać wysoką ocenę pewności błędnym odpowiedziom. Nie potrafią powiedzieć "nie jestem pewien" jak człowiek; przez dane treningowe, założenia modelu i pętle sprzężenia zwrotnego dziedziczą nawet ludzkie błędy poznawcze. Przy wykrywaniu przypadków skrajnych fałszywe pozytywy prowadzą do niepotrzebnych interwencji, a fałszywe negatywy do przeoczenia krytycznych zdarzeń. Co więcej, automatycznie generowane syntetyczne etykiety nie zawsze mogą być wystarczająco wiarygodne do treningu krytycznego dla bezpieczeństwa. Według jednego z ekspertów do niezawodnych pojazdów autonomicznych brakuje jeszcze 10 lat - a w pojeździe źle radzącym sobie ze skrajnymi przypadkami margines błędu jest praktycznie zerowy.
Ile kosztuje nadmierne zaufanie do symulacji?
W tym miejscu dwie obozy stają naprzeciw siebie. Obrońcy mają rację: przez barierę 11 miliardów mil dowód bezpieczeństwa bez symulacji jest praktycznie niemożliwy. Sceptycy też mają rację: czy testowanie oparte na symulacji naprawdę obejmuje wszystkie scenariusze z prawdziwego świata? To pytanie wisi w powietrzu od lat. Nawet własna teza Waymo sugeruje, że sama objętość symulacji nie wystarcza. A Steve Wozniak, jedna ze znanych postaci tej dziedziny, twierdzi, że w nietypowych sytuacjach kierownica powinna trafić nawet w ręce najgłupszego człowieka - punkt sarkastyczny, ale skłaniający do refleksji.
Inny zarzut: obecne metody symulacji jazdy nie potrafią w skalowalny sposób generować ukierunkowanych scenariuszy brzegowych. Czyli znalezienie "tego wyróżniającego, niebezpiecznego momentu" to wciąż częściowo robota dla człowieka. Prace udostępniane na OpenReview szukają rozwiązania tego problemu skalowania, ale trudno powiedzieć, że został już rozwiązany.
Czy pojazdy autonomiczne mogą nauczyć się wszystkiego w symulacji i wyruszyć na drogę?
Krótka odpowiedź: same w sobie nie. Symulacja to bezcenne pole treningowe; ale żaden system nie wyrusza na drogę bez zasilania danymi z prawdziwych dróg i stopniowych testów w rzeczywistości. Nawet najbardziej kompetentny system dzisiaj nie jest w pełni autonomiczny - FSD Tesli, jak wskazuje "Supervised" w nazwie, czyli "pod nadzorem", czeka na dyżur kierowcy. Symulacja to szkoła w cieniu; dyplom wręczany jest na prawdziwej drodze. Najlepszą sztuczną inteligencją kierowcy będzie ta, która połączy wirtualny trening z doświadczeniem na prawdziwej drodze - i nigdy nie zapomni o różnicy między tymi dwoma światami.
Źródła
- Autonomous Vehicle Simulation and Validation
- 6 Reasons to Use Autonomous Vehicle Simulation Software
- Machine Learning in Autonomous Vehicles: Fully Explained
- The Waymo World Model
- Self-Driving Car Technology for a Reliable Ride
- What Is the Sim-to-Real Gap?
- Simulated Tests Cut the Time and Cost of AV Testing
- Tesla vs Waymo - Who Is Closer to Level 5 Autonomy?
- Waymo and Tesla's Self-Driving Systems Are More Similar Than You Think
- Edge Cases in Autonomous Driving: Detection and Management
- Research Reveals Possibly Fatal Consequences of Algorithmic Bias
- Full Self-Driving (Supervised)