让自动驾驶多年来停滞不前的极端情况
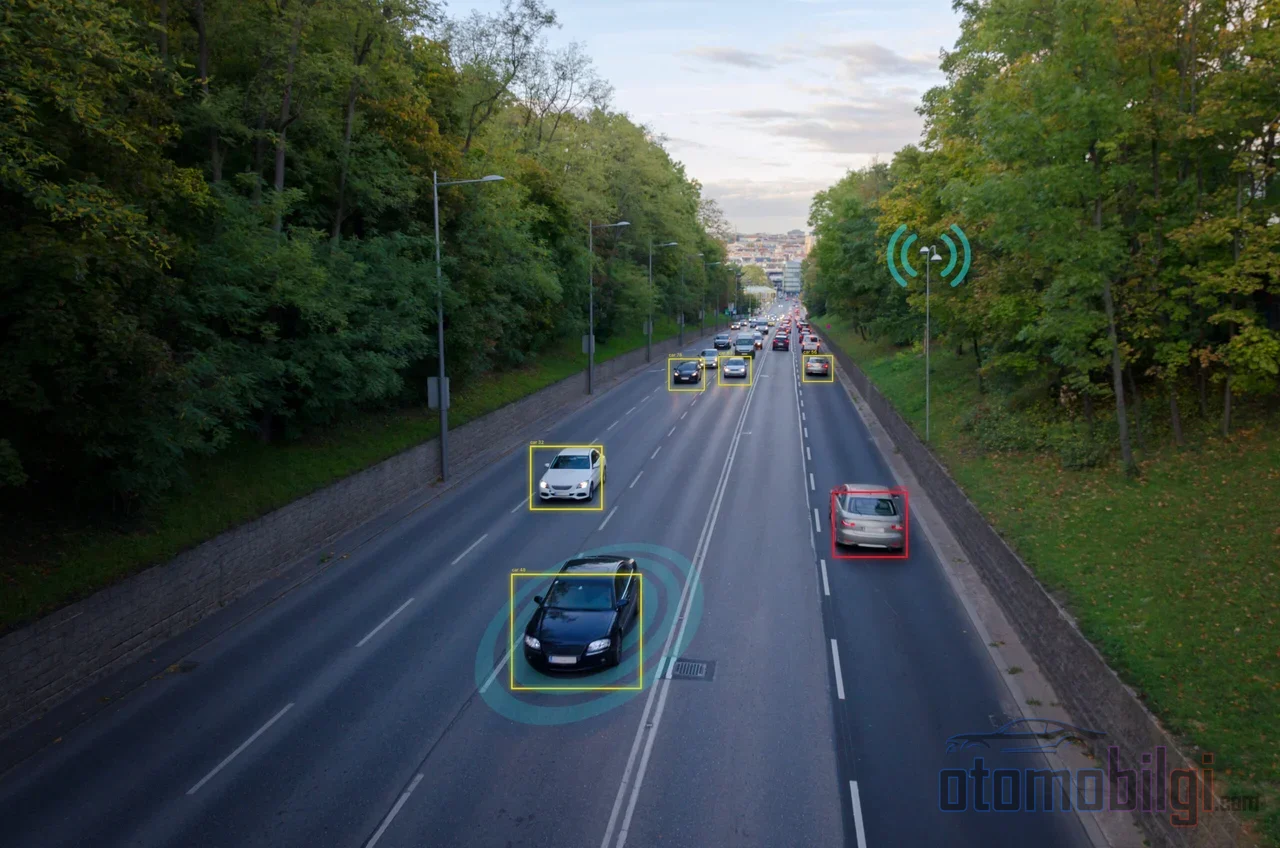
一辆自动驾驶汽车上路后,其99.9%的生命都在重复同样的事情: 在车道上行驶、在红灯前停车、与前车保持距离. 那么真正的问题是: 在那微不足道的剩余片段中,也就是每数百万公里才发生一次的那些奇怪时刻,究竟会发生什么? 正是这些时刻,拖延了自动驾驶“明日就绪”的承诺——而本文将讲述为什么这些问题至今仍未被解决.
什么是边缘情况?长尾为何是另一回事?
我们先来澄清术语,因为这两个概念经常被混淆. 边缘情况 (edge case)是指超出自动驾驶系统训练数据范围的罕见场景: 翻倒在路上的梯子、不寻常的交警手势、异常的天气状况. 这些可以预先定义,至少在理论上如此.
长尾 (long tail)则是一个更令人不安的概念: 所有你连想都想不到的东西的总和. 一夜之间变化的施工现场、雨中从皮卡上滚落的床垫、还有长尾末端那种没有任何人想过要写进问题清单的场景. 如果边缘情况是一个拼图,那么长尾就是一个你不知道有多少块拼图的盒子.
稀有也有多种类型. 第一种是稀有类别: 比如驴、救护车等道路上罕见遇到的物体. 第二种更为隐蔽,即稀有场景: 物体本身很普通,但组合方式很奇怪——比如突然从卡车后面窜出的行人,或者扛着梯子的骑行者. 寻找第二种要难得多,因为系统中的每个组件都已被定义; 问题在于它们组合在一起的方式.
专家将极端情况分为四大类: 环境类(天气、光线条件)、物体类(稀有物体)、行为类(不可预测的道路使用者)和传感器类(硬件故障、盲点). 每个类别本身就是一件令人头疼的事; 而它们加在一起,就解释了为什么这条尾巴如此之长.
要点摘要
- 一个准确率达99%的系统,大约每10,000英里的行驶中就会遇到一次它无法解决的危险场景.
- 在一个常见的数据集中,与汽车相关的标注有493,322个,而救护车的标注仅有49个.
- 在344,966帧公开的标注数据中,最稀有的30个物体类别,每个类别的出现次数都少于250次.
- 如果自动驾驶系统像人类一样驾驶,它们只能预防所有事故中大约三分之一.
用数字看稀有性: 为什么这条尾巴如此之长?
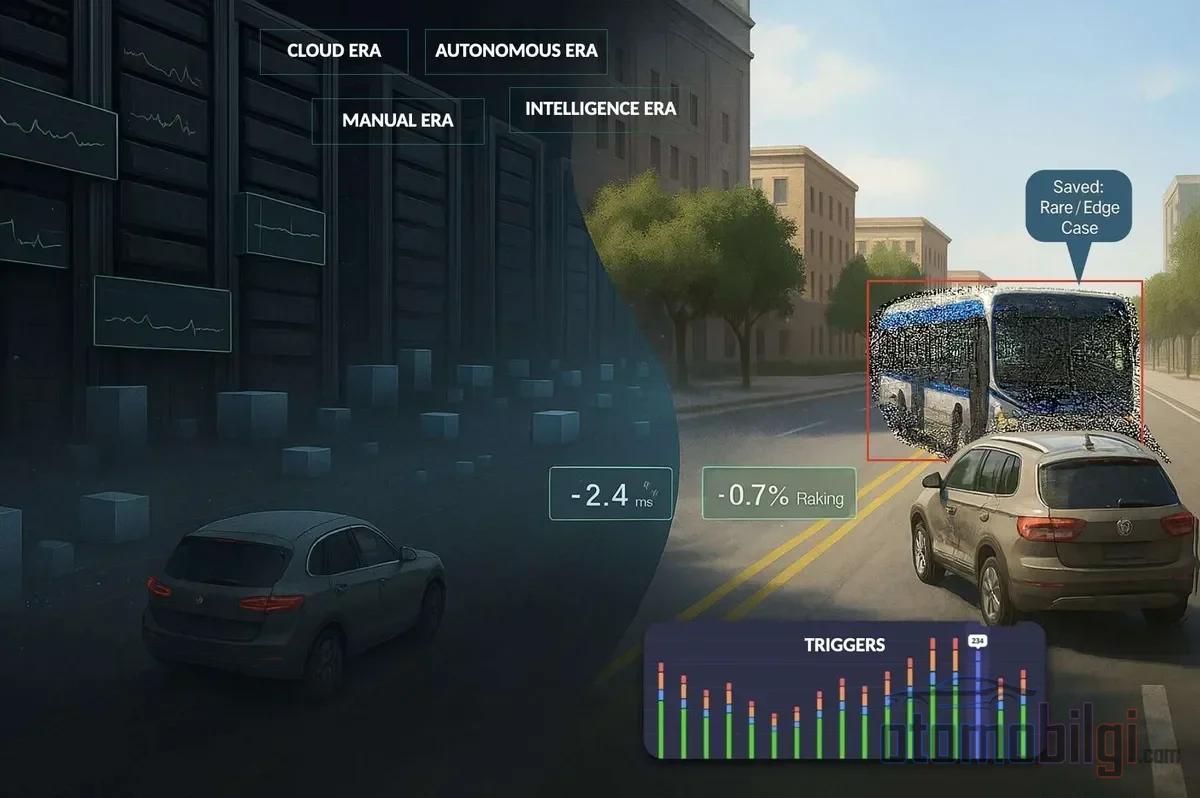
要理解这种稀有性的规模,需要一点数学. 99%的准确率听起来很棒,不是吗? 但算一算账: 一个达到这种准确率的系统,在10,000英里的行驶中大约会有一次落入它自己无法解决的危险场景. 即使对于日常使用,这个数字也非常大——而对于完全自动驾驶来说,更是灾难性的,因为安全阈值要求极低的错误率.
数据方面的图景更加惊人. 作为梅赛德斯-奔驰与埃斯林根大学合作成果的SearchAD基准研究检查了来自11个驾驶数据集的423,798帧画面: 90个罕见类别,513,265个手动标注. 结果呢? 最罕见的30个类别,每一个在344,966帧公开标注数据中出现的次数都少于250次. 在一家专门手动寻找这些罕见案例的公司里,这项工作耗费了八个月,每帧画面平均花费超过一分钟,且每帧至少被审查两次.
| 对象类别 | 示例数据集中的标注数量 |
|---|---|
| 汽车 | 493,322 |
| 婴儿车 | 1,072 |
| 救护车 | 49 |
这张表格展示了世界本身的不均衡性: 汽车无处不在,救护车几乎无处可寻. 而且问题不仅仅在于发现; 基于标签的搜索只会返回预先定义好的类别. 如果没有人给雨中披着垃圾袋的行人贴上标签,那么任何搜索该数据的查询都无法找到它. 总体成功指标也可能将罕见类别中的退化隐藏在强大的整体分数之下.
多收集一些数据不行吗?
答案是压倒性的“不行”,原因可以用一句话概括: 数据的不均衡就是世界的不均衡.从道路上收集的驾驶数据绝大多数充斥着普通行为——车道保持、遵守红绿灯、平直的道路. 当您把数据集翻倍时,增加的很大程度上是两倍的普通样本; 那些罕见样本在队列中反而被埋得更深. 这是经典的收益递减问题: 单纯扩大算力和数据规模,并不能在超低错误率下带来足够的产出.
那么,如果我们在场景中重新创造这些罕见情况呢? 这里就有第二堵墙: 大多数罕见案例要么危险,要么不可能. 把一个会从卡车后方窜出的行人编排成舞蹈,根本无从谈起. 更何况这个队列是开放式的——没有终点,也就是说,“我们全部完成了”的那一刻永远不会到来.
因此,仿真是出色的辅助工具,但不是救世主. 在真实道路上,再多的测试也无法单独保证安全性; 更何况人为制造罕见事件本身就是一项艰难的工程难题. Waymo的方法在这里格外引人注目: 该团队重构了现实中曾导致死亡事故的碰撞场景,并将Waymo Driver置于引发碰撞的车辆位置. 在仿真中,它避开了所有碰撞. 令人印象深刻——但成功完成已定义的场景,并不意味着已经消化了整个队列.
制造商如何应对同一个问题?
Mobileye: 专门猎捕失败的AI
Mobileye在2026年推出的两款工具为这一问题带来了系统性的解决方案. 名为Meteor的多智能体人工智能数据分析员,利用视觉-语言模型嵌入和自动推理,扫描数百万小时的驾驶视频. 它要寻找的东西很有趣: 不是被称为黑天鹅的孤立奇迹,而是可重复的失败 - 部分遮挡的行人、不明确的道路使用者等反复出现的模式. 发现、假设、场景查询、验证和训练数据这一链条是自动处理的. 而名为Genario的伙伴系统则将每一个经过验证的失败转化为照片级逼真的合成场景,并通过白天/黑夜、雨、雪、冰、雾等变体进行复制. 这一切的背后是超过25年的经验、超过2.3亿辆汽车以及每天来自800万辆车的数据上传.
Waymo: 有限的区域,严格的规则
Waymo的战略不是缩短队列,而是缩小队列可以进入的区域. 其所称的运行设计域 (ODD),即运营设计区域; 由地理、道路类型、速度范围、天气和一天中的时段来定义. 根据该公司的监管文件,目标区域包括限速高达65 mph的道路. 车辆完全自主运行; 远程的人类操作员并不用操纵杆驾驶车辆,仅提供高层级的引导. 2026年10月,它还发布了关于事件管理演习的新框架,以应对意外情况. 管理层方面的信息很明确: 自动驾驶车辆可以大幅减少事故,但无法达到100%,因此必须就此坦诚、公开地沟通. 公司数据显示,其Robotaxi每百万英里的事故数远低于往年. 另一个观察则是ODD定义和安全概念可以在多个城市重复使用 - 这种灵活性也促使人们质疑该领域的边界.
Tesla和NVIDIA: 两种不同的押注
Tesla押注的是,数百万辆车和数十亿英里的真实世界数据将随着时间推移照亮队列. 在Full Self-Driving (Supervised)版本中,用户报告的干预更少,且据该公司称,FSD将人为错误导致碰撞的可能性降低了80%以上 - 但这是公司自己的数据,独立验证问题存在争议; Tesla从未发布过任何官方的脱管(disengagement)数据. 用户报告虽然只是轶事层面的,但充满线索: 在前方变道的大型卡车前被迫脱离系统,或是系统在高速公路上高速逼近停在左车道的施工卡车.
NVIDIA则看向相反的方向: 通过模拟和可泛化的智能对未知情况进行推理. Alpamayo-R1项目表明,用推理数据训练的模型在困难案例中将规划准确度提升了最多12%,并将近乎碰撞减少了35%. 这两种哲学 - 就像Mobileye的假设驱动数据挖掘和Wayve的端到端人工智能方法一样 - 尚未被证明是最终的解决方案. 还没有人看到队列的尽头.
远程人工干预: 安全网还是弱点?
Robotaxi公司的实际保障是远程操作: 当系统陷入困境或发生故障时,由远程人类操作员介入接管. 美国参议院的一场听证会揭示,Robotaxi公司所依赖的恰恰正是这一点. 业界早已有共识,认为Cruise的Robotaxi频繁需要远程操作员的干预.
但这个安全网有一个后门. 在Waymo模式下,远程操作员只提供高层级的引导; 并不亲自接管方向盘. 而在特斯拉的奥斯汀Robotaxi发布会上,据称远程支持人员在2 mph及以下的速度下可以临时接管控制、远程驾驶车辆,而且某州交通部门2025年的一份报告证实,特斯拉对罕见的边缘情况和复杂环境采用了远程操作方式. 低延迟的5G和6G连接使这些模式在技术上成为可能. 问题在于: 让人类来解决系统无法解决的场景,究竟是真正的解决方案,还是我们只是把问题转移进了一个看不见的队列?
在承诺与现实之间,法律怎么说?
在这里事情变得严肃起来,因为一桩发生在罕见边缘情况下的车祸,不仅是技术问题,更引出法律问题. 在美国,NHTSA于2026年4月发布了自动驾驶系统规则的更新. 在法律方面,有一个耐人寻味的区别: 车辆符合安全标准并不意味着它完美无缺; 过失索赔主张是一条完全不同的法律途径,而原告律师正是在这里大显身手. 根据德克萨斯州一份法律指南,诉讼中使用的论据,正是公司的承诺与汽车实际表现之间的差距. Brookings提出的技术风险也指向同一个问题: 感知和预测系统中不可预见的错误,可能导致车辆在错误的时间做出错误的事情.
SAE J3016标准中的分级也把承诺与现实摆上了台面. 在从Level 0到Level 5的分级体系中,道路上绝大多数车辆仍处于Level 1或Level 2. Level 3则带来了责任从驾驶人向制造商转移的重大转变. 至于Level 5,一些专家认为: 能在人类可驾驶的任何地方运行的车辆永远不会出现. 甚至2026年的一篇科学论文也指出,现有的分级并不能反映真实世界的能力,并提出了一种基于环境和情境的额外分类方法.
队列可以被消化完吗? 诚实的回答
让我用最直白的方式告诉你: 边缘情况是指统计学上极其罕见却无法预测的场景,它们拖延着自动驾驶实现所承诺的完全自动驾驶;无论是无限量的数据收集还是模拟仿真,都无法单独消化这个开放式队列.乐观一方手中握有真实事故数据: Waymo的数据显示,每百万英里的事故数量确实在下降,而Mobileye的合成场景生成也在系统性地缩小这个队列. 悲观一方手中同样握有事实: 如果像人类一样驾驶,你只能避免大约三分之一的事故; 据一些安全机构称,无人驾驶时代尚未到来,系统仍然经常在基本任务上失败. 而下一场争论已经在门口了: 即使我们以某种方式解决了边缘情况,这一次我们要如何保证通用人工智能模型的准确性?
我的理解是这样的: 自动驾驶不是一场竞赛,而是一条流水线上的淘汰工作. 每天数千公里无故障行驶不会打动任何人; 真正起决定作用的,是每百万英里才出现一次的那个奇怪时刻你做了什么. 而你在那一刻会做什么,早在你设想那个场景的那天就不得而知了. 你觉得robotaxi能打赢这场持久战,还是会永远差一步? 我很想在评论区看到你的看法.
参考资料
- 诊断长尾问题:Mobileye如何将边缘情况转化为针对性训练(Mobileye博客)
- 为什么自动驾驶模型会漏掉罕见边缘情况(以及如何找到它们)| Voxel51
- 自动驾驶中的边缘情况:检测与处理指南 | Kognic
- Waymo在重建的致命事故中模拟驾驶行为(Scanlon等人,2021,ScienceDirect)
- 为意外做好准备:自动驾驶汽车事件管理演练的新框架(Waymo博客,2026年10月)
- 完全自动驾驶(监督版)车辆安全报告(Tesla)
- 用端到端AI解决长尾问题(Wayve)
- SAE驾驶自动化分级(SAE International)
- 自动驾驶汽车可能难以消除大多数事故(IIHS)
- 美国州交通部门政策与监管方法(NCDOT,2025)