자율주행차는 보행자와 어떻게 소통할까?
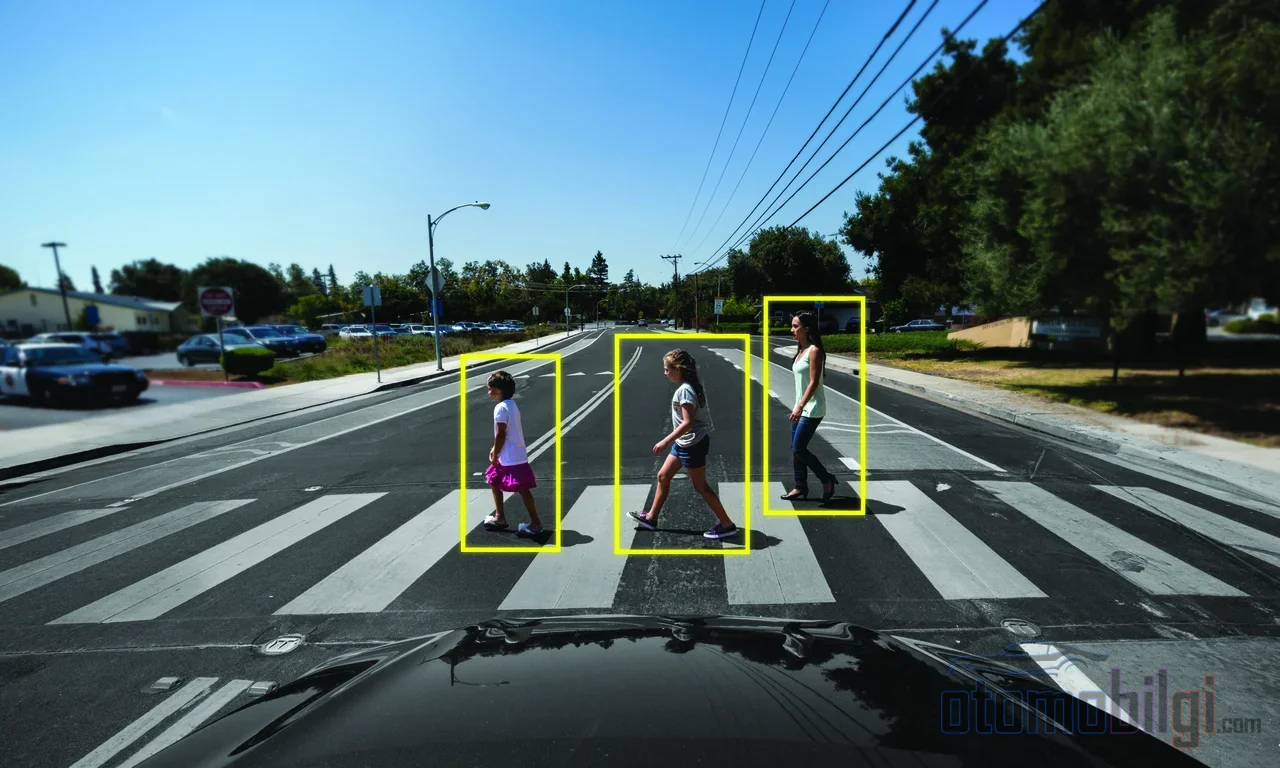
차로를 건너려던 순간 운전자와 눈이 마주칩니다; 운전자는 살짝 속도를 줄였음을 알리고, 두 낯선 사람은 순식간에 서로를 이해합니다. 그런데 맞은편 좌석에 아무도 없다면 어떨까요? 자율주행차는 과연 보행자와 어떻게 소통하고 있을까요 - 그리고 그 소통은 정말 우리가 생각하는 방식과 같을까요? 바로 이 질문은 자동차에 뜨거운 열정을 쏟아붓는 사람에게는 놀랍도록 재미있는 여정이 되는데, 그 이유는 답이 생각보다 훨씬 흥미롭기 때문입니다.
보행자 감지: 차는 당신을 어떻게 '보고' 있을까?
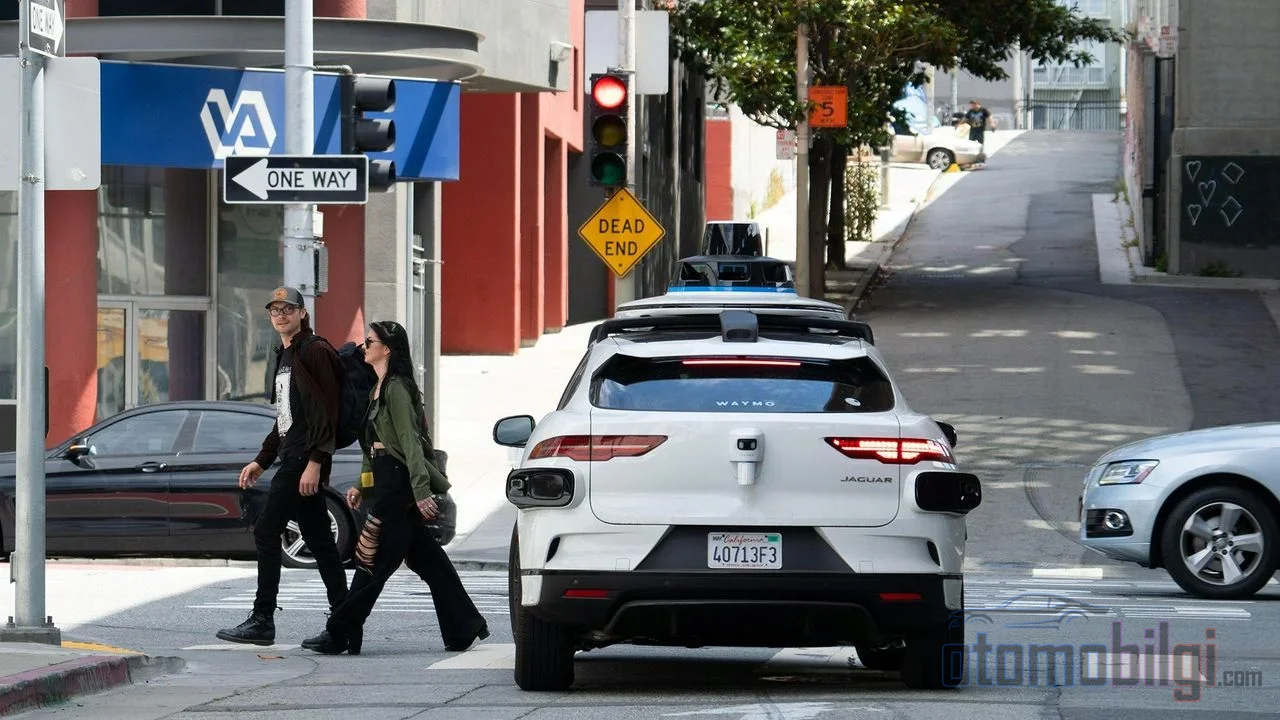
먼저 이것부터 분명히 하자: 자율주행차의 눈은 당신의 눈과 다릅니다. 라이다, 레이더, 카메라가 함께 작동하여 주변의 모든 것을 포인트 클라우드와 영상의 혼합물로 변환하고; 그다음 인공지능이 이 데이터 더미 속에서 자전거 타는 사람, 킥보드 이용자, 보행자를 가려냅니다. 즉, 차가 당신을 '본다'는 것은 사실 당신을 끊임없이 다시 계산하고 있다는 뜻입니다. 과학 소설 같게 들리죠?
그런데 진짜 핵심은 감지 이후에 시작됩니다: 바로 예측입니다. 보행자 의도 예측 연구에는 입력, 특징 추출, 예측의 3단계 구조가 있습니다. 차량은 보행자를 향한 모든 신호를 수집하고, 이를 의미 있는 패턴으로 부호화한 후, 마침내 다음 질문에 답하려 합니다: 이 사람이 도로로 뛰어들까, 아니면 인도에 머물까? 당신이 한 번의 시선으로 하는 일을, 차량은 배경에서 초당 수천 번 반복하는 수학 경쟁으로 처리합니다.
핵심 요점
- 많은 보행자가 다가오는 차량과 눈을 마주쳤다고 믿지만 - 사실은 대부분의 운전자를 전혀 보지 못합니다.
- 눈 접촉이 없을 때 운전자의 약 55%는 횡단보도에서 멈추지 않습니다.
- 의도 예측에서 가장 중요한 신호는 보행자 자신이 아니라 상황 그 자체입니다; 맥락이 제거되면 성능이 급격히 떨어집니다.
- 차량 상부의 로봇 눈은 안전감을 높이지만 참가자들은 이를 필수라고 보지 않습니다.
- 백만 주행 km당 4에서 5.5 사이의 예상 충돌 건수는 보행자-자율주행차 상호작용을 여전히 위험하게 만듭니다.
눈 접촉 신화: 당신을 바라보는 사람이 없는데 우리는 무엇을 믿고 있을까?
바로 여기서 일이 정말 흥미로워집니다. 운전자-보행자 눈 접촉 실험에서 놀라운 사실이 드러났습니다: 많은 사람이 다가오는 차량의 운전자와 눈을 마주쳤다고 확신합니다. 그러나 실험 기록은 사실 아무도 그 운전자를 보지 못했다는 것을 보여줍니다. 즉, 인간의 뇌는 실제 시선이 아니라 그 시선을 상상하는 것만으로도 신뢰감을 만들어낼 수 있는 것입니다. 놀랍죠, 그야말로 그 단어의 의미 그대로입니다.
한편 눈 접촉이 실제로 효과를 발휘하는 경우도 있습니다: 운전자와 눈이 마주친 보행자는 횡단할 때 더 안전하다고 느끼며, 횡단보도에서 멈추는 비율도 달라집니다 - 눈 접촉이 없으면 운전자의 약 55%는 멈추지조차 않습니다. 하지만 주의하세요: 이 단서는 차량의 움직임 단서가 불분명한 상황에서만 결정적인 역할을 합니다. 그리고 자율주행차에는 그 단서가 애초에 없습니다. 즉, '운전자를 봤고, 그가 나를 봤다'는 전통적인 신뢰는 운전자 없는 차량의 시대에 근거를 잃게 됩니다. 그렇다면 그 대신 무엇이 왔을까요?
멈출까, 갈까? 정지-출발 판단의 해부학
자율 시스템이 가장 어려워하는 순간은 교차로와 횡단보도에서의 바로 그 망설임의 순간입니다. 연구자들은 여기서 두 가지 서로 다른 개념을 엄밀하게 구분합니다: crossing intention, 즉 보행자의 내적 판단과 crossing prediction, 즉 차량의 "이 사람이 길에 나설 것이다"라는 예측입니다. 차이를 느껴보려면 이렇게 생각해 보세요: 친구의 손에 하이파이브를 하기로 결심하는 것과 그 하이파이브가 실제로 이루어지는 것의 차이입니다. 차량은 이 둘을 모두 정확하게 예측해야 합니다.
잘못된 예측은 양쪽 모두에 해를 끼칩니다: 불필요하게 망설여서 교통이 정체되거나, 안전하지 않은 기동을 시도하게 됩니다. 그래서 의도 예측 모델은 끊임없이 발전하고 있습니다. 최근에는 주시와 시선, 위치, 상태, 상호작용이라는 네 가지 행동 흐름을 결합한 경량 Transformer 모델이 교차로에서의 판단을 높은 정확도로 예측했습니다. 더 흥미로운 것은 ablation, 즉 구성 요소 제거 실험입니다: 상태 정보를 모델에서 제거하자 성능이 무너졌습니다. 요컨대 차량이 얻는 가장 강력한 신호는 보행자 자신이 아니라, 보행자가 처해 있는 맥락입니다.
이 분야에는 영상뿐만 아니라 인간 운전자의 자연어 설명에 기반한 라벨링된 데이터 세트와, 신호등 없는 교차로에서의 우선권 문제를 다룬 LSTM 기반 연구들도 있습니다. 그리고 2025년 말에 큰 도약이 있었습니다: 멀티모달 대규모 언어 모델을 사용하는 OmniPredict라는 시스템이 인간 보행자 행동을 실시간으로 예측하는 최초의 모델로 부상했습니다. 차량은 여러분 머릿속에 있는 그 빠른 직관을 조금씩 배워가고 있습니다.
차량에 얼굴을 달다: eHMI 실험은 정말 효과가 있을까?
운전자와 보행자는 예전에 손짓, 표정 같은 비공식적인 신호로 소통했습니다. 자율주행차 개발자들도 이러한 신호를 기계에 옮기려 했고, 외부 통신 인터페이스, 즉 eHMI 실험이 시작되었습니다. 초기의 중요한 실험 중 하나에서, 자율주행차를 대표하는 캠핑카가 보행자들에게 언제 건널 수 있는지 알려주는 정보를 제공했습니다; 이후에는 화면, 빛 띠, 그리고 차량 위에 장착된 로봇 눈까지 시도되었습니다.
로봇 눈의 현장 실험 결과는 상당히 엇갈립니다 - 그리고 저는 바로 그렇기 때문에 가치 있다고 생각합니다. 눈을 인지한 사람들에게서 안전감이 높아졌고, 별도의 360° 영상 실험에서는 이 눈이 잠재적인 교통사고를 줄일 수 있음이 입증되었습니다. 하지만 같은 참가자들은 눈이 "필요하지" 않다고 생각했습니다. 즉, 귀여운 차량 얼굴은 우리에게 호감을 주지만 필수는 아닙니다. 업계 측면에서도 비슷한 입장을 보입니다: 보행자가 편안함을 느끼려면 차량의 행동을 인간이 자연스럽게 이해하는 방식으로 표현해야 하며, Science에 실린 한 분석은 교차로의 보행자들이 차량이 자신을 "봤다는" 확인을 기다린다고 강조합니다.
다만 여기에는 기묘한 역설이 하나 있고, 그것을 짚고 넘어가야 합니다: 통신 설계를 아무리 개선해도 위험한 사용자 행동은 막지 못할 수 있습니다. 아동 보행자 실험에 따르면, 자율주행차가 교차로에서 멀어진 후에도 녹색 신호를 켜고 감속하더라도 아이들이 더 위험한 횡단 행동을 보이는 것으로 나타났습니다. 즉, 화면에 "건너도 됩니다"라고 표시하는 것이 아이의 "그럼 뛰어가야지"라는 행동을 막지는 못합니다. 기술이 아무리 좋아도 인간 측면은 여전히 가장 변동성이 큰 변수입니다.
사고는 왜 하필 이 상호작용 순간에 발생할까요?
이제 냉정한 부분으로 넘어가겠습니다. 보행자-자율주행차 상호작용 안전 모델링은 상호작용에서 예상되는 충돌 건수를 차량 100만 km당 4에서 5.5 사이로 계산하며, 이 수치는 명백히 우려스러운 위험 수준으로 평가되고 있습니다. 게다가 전통적인 보행자 사고의 근원도 같은 영역에 있습니다: 보행자 사고의 약 절반이 횡단시설에서 먼 지점, 대부분 주차된 차량 옆에서 발생합니다. 즉, 문제는 주로 "차가 나를 보지 못한" 순간이 아니라, 차가 나와 협상해야만 하는 순간에 터집니다.
알고리즘도 곤란해하는 보행자 유형이 있습니다: 큰 물건을 옮기는 사람, 개를 산책시키는 사람, 또는 별난 복장을 한 보행자는 감지 시스템을 지연시키거나 혼란스럽게 만들 수 있습니다. 부분적 가림, 붐비는 장면, 그리고 모호한 단서도 어려움의 지점 중 하나입니다. 2018년 애리조나에서 자율주행차가 일으킨 최초의 보행자 사망 사고는 바로 이런 유형의 시나리오에서 발생했습니다: 보행자는 차가 멈출 수 없는 거리에 있었습니다. 이 분야에서 초기의 감지 불공정 연구도 기억에 남습니다; 어두운 피부색의 보행자 인식이 어려워진다는 주장은 당시 논쟁을 불러일으켰으며, 이 주제는 오늘날에도 여전히 진지하게 다뤄져야 할 사안입니다.
투명성 격차: 누가 데이터를 공유하고, 누가 공유하지 않는가?
업계의 또 다른 긴장은 안전 데이터의 공유입니다. Waymo는 자사 차량이 인간 운전자보다 다섯 배, 보행자 상호작용에서는 12배 더 안전하다는 연구를 발표하고 안전 데이터를 자발적으로 공개합니다. 반면 업계 비판이 있은 후 Tesla는 상세한 안전 데이터 발표를 중단했습니다. 같은 시장에서 한쪽은 데이터를 쏟아내고 다른 쪽은 커튼을 치니, 대중의 손에 공정한 비교 수단이 남지 않습니다.
인식 측면에서도 흥미로운 왜곡이 하나 있습니다: 사람들은 자율주행차를, 결함이 없더라도 인간 운전자보다 더 많이 비난합니다. 즉, 기계의 실수는 용서받지 못하는 동안 인간의 실수는 당연한 일이 됩니다. 대중 인식과 데이터 사이의 이 격차는 기술의 실제 성과를 가릴 만큼 큽니다.
그렇다면 자율주행차는 결국 보행자와 어떻게 소통할까요?
제가 약속한 명쾌한 답이 여기 있습니다: 자율주행차는 보행자와 눈맞춤이 아니라 行동 해석 으로 소통합니다. 센서는 보행자를 지속적으로 추적하고, 인공지능은 속도, 위치, 시선, 맥락을 결합해 의도를 예측합니다; 필요할 때는 eHMI 디스플레이나 차량의 행동 - 뚜렷한 감속, 뚜렷한 정지 - 으로 메시지를 외부에 전달합니다. 새로운 합의의 언어는 낡은 눈빛 교환이 아니라 움직임과 맥락입니다. 여러분은 걸음걸이로 자신의 의도를 전하고, 차는 브레이크로 자신의 결정을 알려줍니다.
제 요약은 이렇습니다: 기계 쪽의 예측은 해마다 더 정확해지지만, 상호작용은 여전히 양방향의 게임입니다. 데이터 공유의 투명성, eHMI 설계의 겸손함, 그리고 사용자인 우리의 조금 더 많은 인내가 없다면 이 합의는 불완전하게 남습니다. 여러분이라면 눈을 믿으시겠습니까, 아니면 브레이크 소리를 믿으시겠습니까? 저는 후자라고 생각합니다 - 하지만 로봇 눈의 그 귀여움도 한몫하겠죠.
참고 자료
- Pedestrian Crossing Intent Prediction via Psychological Features and Transformer Fusion
- Pedestrian Intention Prediction for Autonomous Vehicles
- Pedestrian Intention Prediction Using LSTM for Right-of-Way
- Eye Contact Between Pedestrians and Drivers
- Safe Crossings: The Power of Eye Contact
- External Human-Machine Interfaces for Autonomous Vehicles
- Evaluation of Vehicle-to-Pedestrian Communication Displays
- A Field Study on Pedestrians' Thoughts toward a Car with Eyes
- Can AI read humans' minds? A pedestrian behavior model
- Waymo Safety Impact