自動運転車は歩行者とどのように意思疎通しているのか?
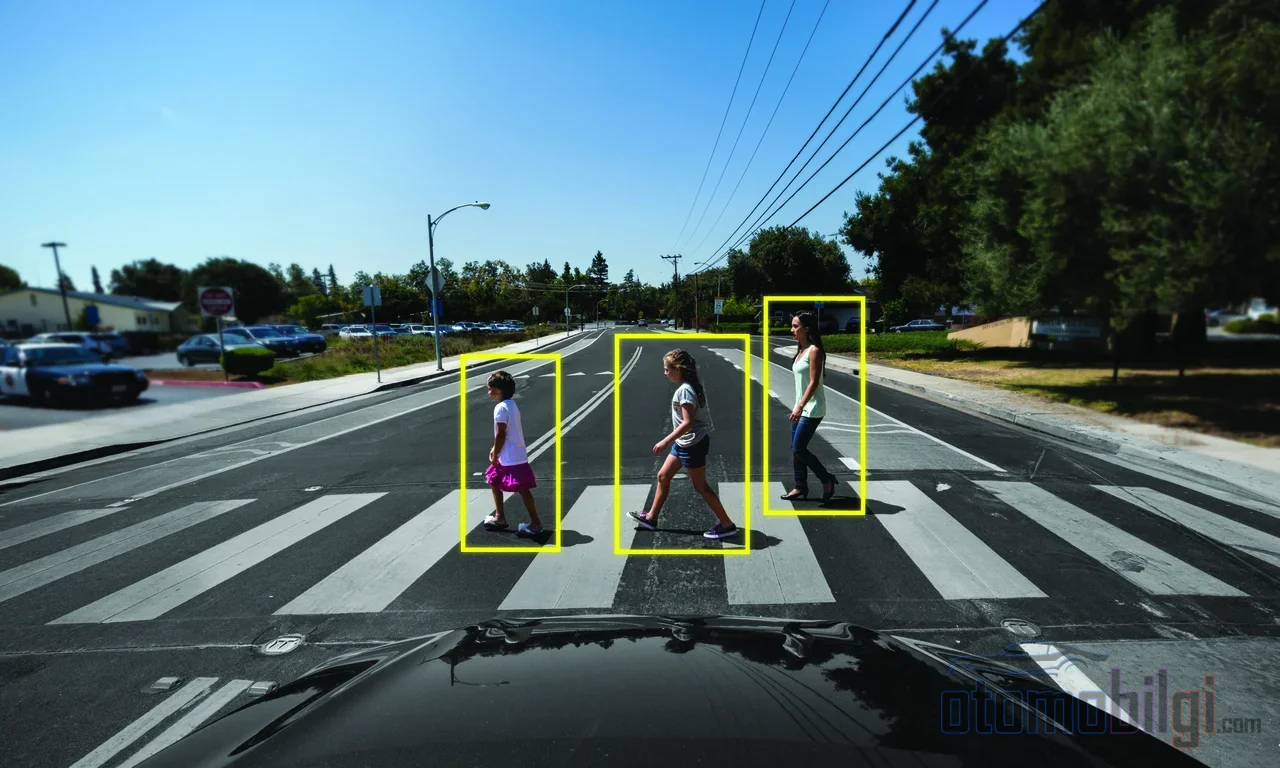
反対側へ渡ろうとしているとき、あなたはドライバーの目を見ます. 相手は少しスピードを落としたことを示し、二人の見知らぬ人は一瞬で理解し合います. でも、向かいの席に誰もいなかったら? 自動運転車は歩行者とどのように意思疎通をしているのか - そしてそのやり取りは本当に私たちが思っている通りなのでしょうか? この問いは、車に情熱を注ぐ人にとって実に楽しい旅になります.なぜなら、答えは想像以上に興味深いからです.
歩行者検知: 車はあなたをどう「見ている」のか?
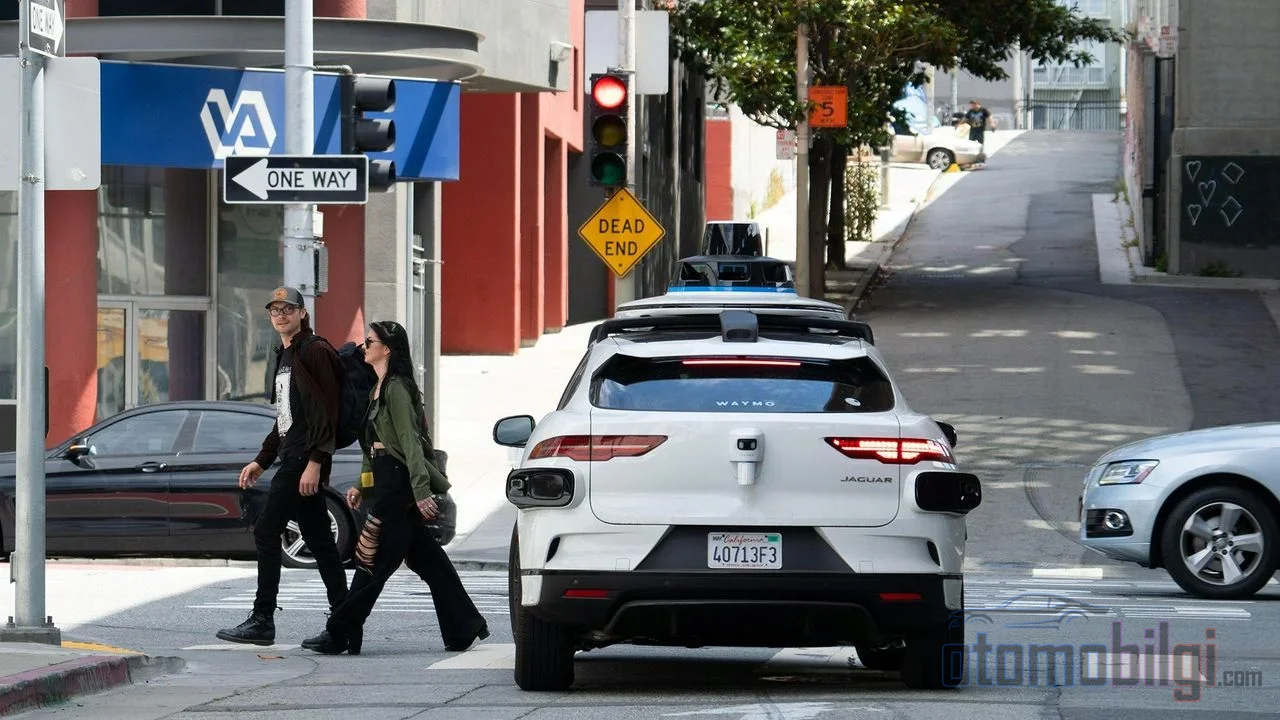
まずはっきりさせておきましょう: 自動運転車の「目」は、あなたの目とは違います. LiDAR、レーダー、カメラが連携して、周囲のすべてを点群と画像のミックスに変換します. そしてAIがその膨大なデータの中から自転車、スクーター利用者、歩行者を識別します. つまり、車があなたを「見ている」というのは、実際には絶えずあなたを再計算し続けているという意味です. SFみたいに聞こえますよね?
本当の肝心な部分は、検知の後から始まります: 予測です. 歩行者の意図予測の研究には、入力、特徴抽出、予測という3段階のプロセスがあります. 車は歩行者に向けたすべての信号を収集し、意味のあるパターンにコード化し、最終的に次の問いに答えようとします: この人は飛び出すのか、それとも歩道に留まるのか? あなたが一瞥でやっていることは、バックグラウンドで1秒間に数千回繰り返される数学の競争なのです.
注目ポイント
- 多くの歩行者は、近づいてくる車の運転手と目が合ったと信じています - しかし実際には、ほとんどの運転手を見ていません.
- 目が合わない場合、ドライバーの約55%は横断歩道で止まりません.
- 意図予測において最も重要な信号は、歩行者ではなく状況そのものです. 文脈が取り除かれると、パフォーマンスは急激に低下します.
- 車両上部のロボットの目は安心感を高めますが、参加者はそれを必須とは考えていません.
- 100万車両キロあたり4~5.5件の予想衝突数は、歩行者と自動運転車の相互作用を依然としてリスクのあるものにしています.
アイコンタクトの神話: 誰もあなたを見ていないとき、私たちは何を信じているのか?
ここからが本当に面白くなるところです. ドライバーと歩行者のアイコンタクト実験で、驚くべきことが判明しました: 多くの人が、近づいてくる車の運転手と目が合ったと確信しています. しかし実験の記録は、その運転手を実際には誰も見ていなかったことを示しています. つまり人間の脳は、安心感を実際の視線ではなく、視線を思い込むことから生み出せるのです. 驚きです、文字通りにも figuratively にもではなく.
ちなみに、アイコンタクトが実際に効果を発揮する場面もあります: 運転手と目が合った歩行者は、渡るときにより安心感を感じており、横断歩道で止まる率も変化します - 目が合わない場合、ドライバーの約55%は止まりさえしません. しかし注意してください: この手がかりは、車の動きの手がかりが曖昧な場合にのみ決定的な役割を果たします. そして自動運転車には、その手がかりが最初から存在しません. つまり、「運転手を見た、私に気づいてくれた」という従来の信頼は、ドライバーのいない車の時代には根拠を失います. では、その代わりに何が生まれたのでしょうか?
止まるか、通過するか? 停止・発進判断の解剖学
自律システムが最も苦労する瞬間、それは交差点や横断歩道でのあの躊躇の瞬間です. 研究者たちはここで、二つの異なる概念を厳密に区別しています: crossing intention、すなわち歩行者の内面的な決断と、crossing prediction、すなわち車両による「この人は道路に進出するだろう」という予測です. その違いを感覚的に理解するには、こう考えてみてください: 友人がハイタッチしようと決めることと、そのハイタッチが実際に成立することの違いです. 車両はこの両方を正確に予測しなければなりません.
誤った予測は両極端に悪影響を及ぼします: 不必要に躊躇して交通が渋滞するか、あるいは安全でない操縦を試みてしまうかです. そのため、意図予測モデルは絶えず進化しています. 近年では、注意と視線、位置、状況、相互作用という四つの行動フローを統合した軽量なTransformerモデルが、交差点での判断を高い精度で予測しました. さらに興味深いのは、ablation、つまり構成要素を取り除く実験です: 状況情報をモデルから取り除くと、性能が崩壊します. 要するに、車両にとって最も強力なシグナルは歩行者そのものではなく、歩行者を取り巻く文脈なのです.
この分野ではまた、画像だけでなく人間のドライバーによる自然言語の説明に基づくアノテーション付きデータセットや、信号のない交差点における優先権の問題に関するLSTMベースの研究もあります. そして2025年末に大きな飛躍が訪れました: マルチモーダル大規模言語モデルを使用したOmniPredictというシステムが、人間の歩行者行動をリアルタイムで予測する初のモデルとして登場しました. 車両は徐々に、あなたの頭の中にあるあの直感的な洞察を学び取っているのです.
車に顔をつける: eHMI実験は本当に役立っているのか?
ドライバーと歩行者は昔、手振りや表情といった非公式の手がかりで意思疎通していました. 自律車両の開発者たちもこの手がかりを機械に移そうと試み、外部コミュニケーションインターフェース、すなわちeHMIの実験が始まりました. 最初の重要な実験の一つでは、自律車両を表すキャラバンが歩行者にいつ渡れるかを知らせる情報を提供しました; その後、ディスプレイや光のストリップ、さらには車両の上に取り付けられたロボットの目まで試されました.
ロボットの目に関するフィールド調査の結果はかなりまちまちですが、だからこそ価値があると私は思います. 目に気づいた人々の間では安全の感覚が高まり、別の360°動画実験では、この目が潜在的な交通事故を減らせる可能性があることが示されました. しかし同じ参加者たちは、目が「必要」だとは考えていません. つまり、愛嬌のある車の顔は好まれますが、必須ではないのです. 業界側も似たようなことを言っています: 歩行者が安心できるためには、車両の挙動を人間が自然に理解できる形で表現する必要があり、Science誌に掲載された分析では、交差点の歩行者は車両から「見られている」ことの確認を待っていると強調されています.
ただし、ここには奇妙なパラドックスがあり、それを見過ごすわけにはいきません: コミュニケーションデザインをどれだけ改善しても、危険なユーザー行動を防げない可能性があるのです. 子供の歩行者実験により、自動運転車が交差点から離れて青信号を出し減速したとしても、子供たちはよりリスクの高い横断行動を示すことが明らかになりました. つまり、画面に「渡れます」と表示しても、子供が「じゃあ走ろう」と考えるのを止められないのです. テクノロジーがどれほど優れていても、人間の側が依然として最も変動の大きい変数なのです.
なぜ事故はまさにこの相互作用の瞬間に起きるのか?
ここからは辛らつな部分に入りましょう. 歩行者と自動運転車の相互作用安全性モデルは、相互作用における予想衝突回数を100万車キロあたり4から5.5の間と計算しており、この値は明らかに懸念すべきリスクレベルと評価されています. しかも、従来の歩行者事故の発生源も同じ領域にあります: 歩行者事故の約半数は、横断施設から離れた地点、多くの場合は駐車中の車のそばで発生しています. つまり、問題は主に「車が私を見ていない」瞬間ではなく、車が私と交渉せざるを得ない瞬間に噴出するのです.
アルゴリズムさえも苦労する歩行者のタイプがあります: 大きな荷物を運ぶ人、犬を散歩させる人、あるいは変わった服装の歩行者は、検知システムを遅延させたり混乱させたりすることがあります. 部分的に隠れること、混雑した場面、曖昧な手がかりも、苦労するポイントの中に含まれます. 2018年にアリゾナ州で自動運転車が引き起こした初めての歩行者死亡事故は、まさにこの種のシナリオで起きました: 歩行者は、車が停止できない距離にいました. この分野では、早期の検知の不公平性に関する研究も記憶に残っています. 色の濃い肌の歩行者の検知が困難になるという主張は当時議論を巻き起こし、このテーマは今日でも真剣に取り組むべき課題であり続けています.
透明性の格差: 誰がデータを共有し、誰が共有しないのか?
業界におけるもう一つの緊張は、安全性データの共有です. Waymoは、自社の車両が人間のドライバーより5倍、歩行者との相互作用では12倍安全であることを示す研究を公開し、安全性データを自主的に開示しています. 一方、業界批判を受けてTeslaは、詳細な安全性データの公開をやめました. 同じ市場で一方はデータを公開し、もう一方は幕を引く — これでは世論の手に公平な比較手段が残りません.
さらに認識の面には興味深い歪みがあります: 人々は、自動運転車に欠陥がなかったとしても、人間のドライバーよりも多くの責任を負わせています. つまり、機械のミスは許されないのに、人間のミスは日常茶飯事として片付けられるのです. 世論の認識とデータの間にあるこの格差は、テクノロジーの本当の成功を覆い隠してしまうほど大きいのです.
では、自動運転車は結局のところ歩行者とどのように意思疎通しているのか?
約束した明確な答えはこちらです: 自動運転車は歩行者と視線ではなく、行動の読み取りによって意思疎通しています. センサーは歩行者を継続的に追跡し、人工知能が速度、位置、視線、文脈を組み合わせて意図を予測します. 必要な場合には、eHMIディスプレイや車両の挙動 — 明確な減速、明確な停止 — がメッセージを外に伝えます. 新しい合意の言語は、昔の視線交わしではなく、動きと文脈なのです. あなたは歩く様子で意図を伝え、車はブレーキでその決断をあなたに語りかけます.
私のまとめはこうです: マシン側の予測は年々向上していますが、インタラクションは依然として双方向のゲームであり続けます. データ共有における透明性、eHMIデザインにおける謙虚さ、そして私たちユーザーのもう少しの辛抱がなければ、この合意は不完全なままです. もしあなたがドライバーなら、目を信じますか、それともブレーキ音を信じますか? 私は後者だと思いますが、ロボットの目のあのかわいらしさも言うまでもありません.