自动驾驶汽车如何与行人沟通?
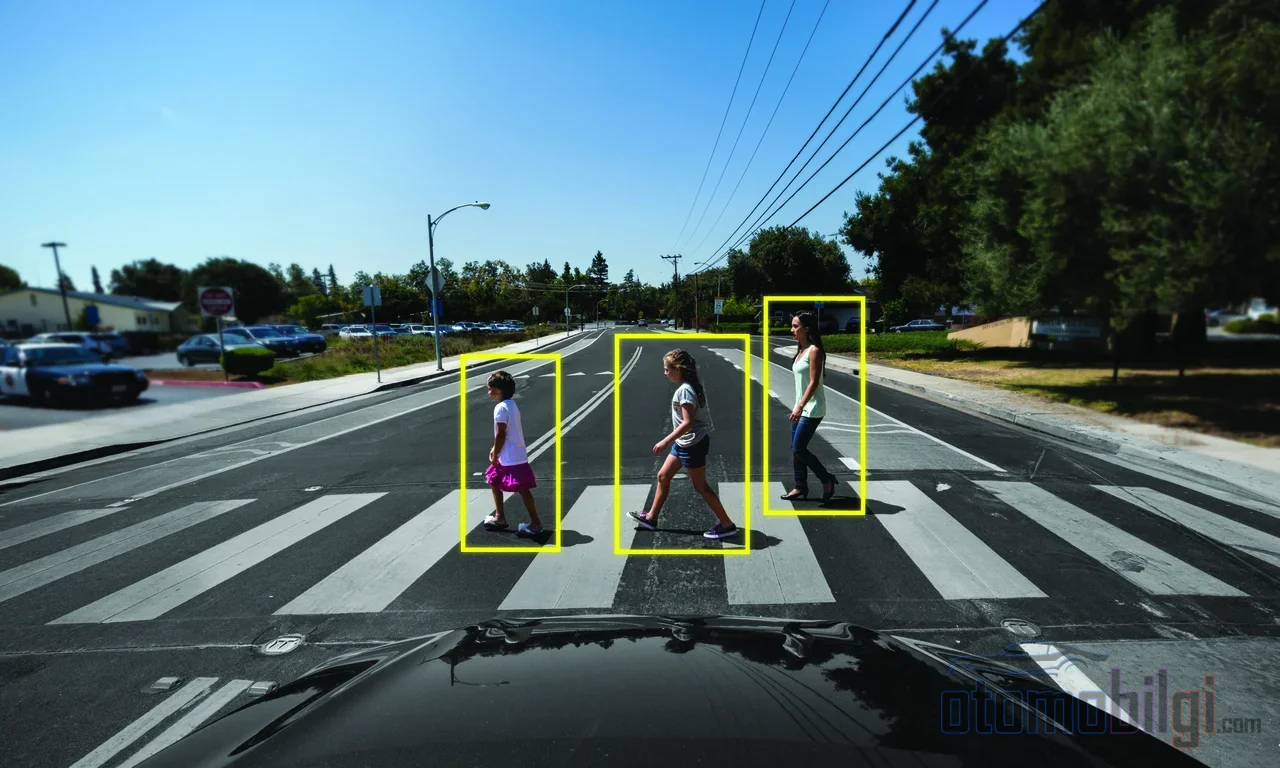
当您正准备横穿马路时,您会望向司机的眼睛; 司机也微微减速示意,两个陌生人在一瞬间达成了默契. 可如果对面的座位上空无一人呢? 自动驾驶汽车到底是如何与行人沟通的——而这种沟通真的像我们想的那样运作吗? 正是这个问题,对于一个痴迷于汽车的人来说,变成了一段无比有趣的旅程,因为答案比您想象的要奇妙得多.
行人检测: 汽车是如何"看到"您的?
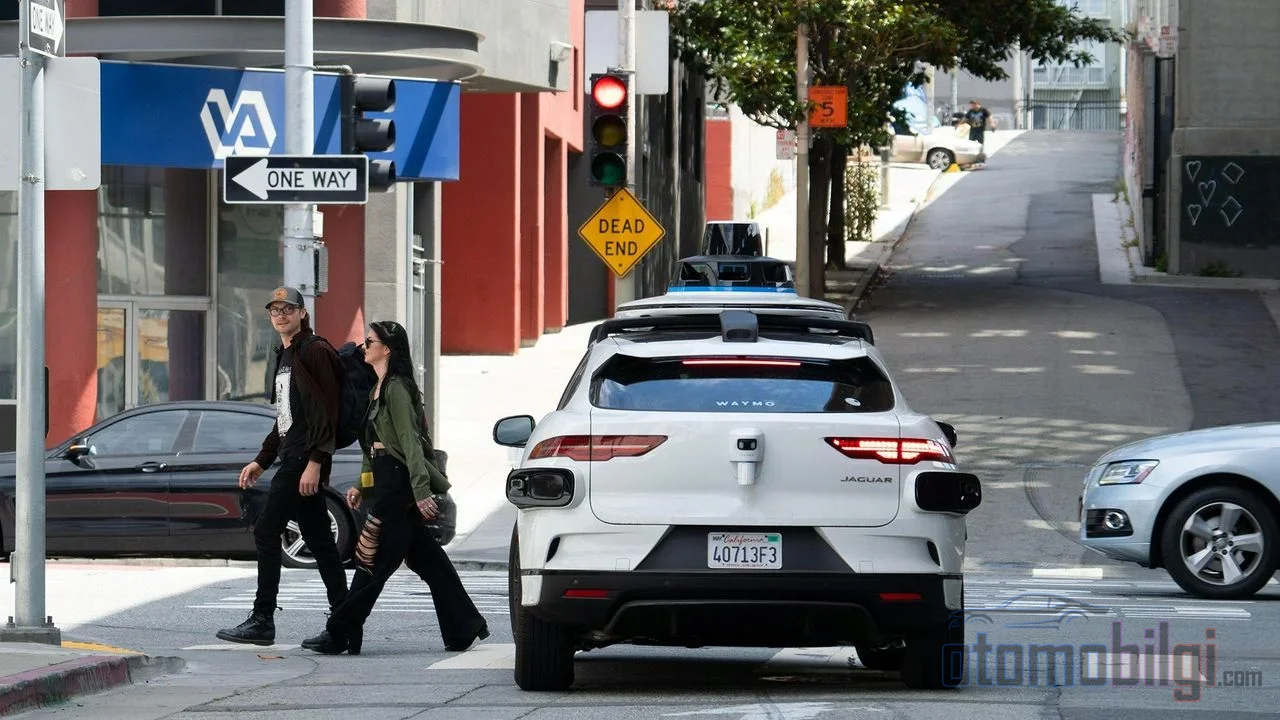
首先必须明确一点: 自动驾驶汽车的眼睛与您的眼睛并不相同. Lidar(激光雷达)、雷达和摄像头协同工作,将周围的一切转化为点云与图像的混合体; 然后人工智能从这堆数据中分辨出骑行者、滑板车使用者和行人. 所以说汽车"看到"了您,实际上是说它在持续不断地重新计算您的位置. 这听起来像科幻小说,不是吗?
而真正关键的环节是在检测之后才开始的: 预测. 在行人意图预测的研究中,存在一个三阶段的结构——输入、特征提取和预测. 汽车收集所有指向行人的信号,将它们编码为有意义的模式,最终回答这样一个问题: 这个人会冲上马路,还是会留在人行道上? 您用一眼就能做到的事情,背后是每秒重复数千次的数学竞赛.
要点速览
- 许多行人认为自己与驶近的车辆有眼神接触——实际上他们根本没有看到大多数司机.
- 没有眼神接触时,约55%的司机不会在人行横道前停车.
- 意图预测中最关键的信号,不是行人本身,而是所处的情境; 一旦去除情境因素,性能就会急剧下降.
- 车顶上的机器眼提升了安全感,但参与者并不认为它们是必需的.
- 每百万车辆公里4至5.5起的预期碰撞数,仍使行人——自动驾驶汽车的交互充满风险.
眼神接触的迷思: 当没有人看到您时,我们到底在信任什么?
正是在这里,事情变得真正有趣起来. 在司机——行人眼神接触实验中,出现了一个惊人的发现: 许多人都确信自己与驶近车辆的司机有过眼神接触. 然而实验记录显示,实际上根本没有人看到那位司机. 也就是说,人脑可以不依靠真实的注视,而是凭借对那份注视的想象来产生信任感. 令人震惊,而且是名副其实的"看"法.
不过,眼神接触确实起作用的场景也是存在的: 与司机对上视线的行人在过马路时感到更安全,人行横道前的停车率也会变化——没有眼神接触时,约55%的司机甚至根本不停. 但请注意: 这一线索只在车辆运动迹象模糊不清的情况下才起决定作用. 而在自动驾驶汽车上,这一线索本来就不存在. 因此,传统的"我看了司机,司机看到我了"这种信任,在无人驾驶时代失去了根基. 那么取而代之的是什么?
停,还是行? 走走停停决策的剖析
自主系统最艰难的时刻,就是路口和通道处那犹豫的一瞬. 研究人员在这里严格区分两个不同的概念: 过街意图,即行人内心的决定,以及过街预测,即车辆"这个人会走到路上"的预判. 为了体会这个区别,可以这样想: 就像你的朋友决定跟你击掌,以及那一击是否真的拍上了. 车辆需要对两者都做出正确预测.
错误的预测对两端都有害: 要么造成不必要的犹豫和交通拥堵,要么尝试不安全的机动. 因此,意图预测模型在不断改进. 最近,一个融合了四种行为流——注意力与视线、位置、状态和交互——的轻量级Transformer模型,以高准确率预测了路口决策. 更有意思的是消融实验,也就是移除某个组件的实验: 当状态信息从模型中移除时,性能急剧下降. 简而言之,车辆最强的信号不是行人本身,而是行人所处的上下文.
该领域还有仅依赖图像的研究,以及基于人类司机自然语言描述的标注数据集,和针对无信号灯路口路权问题的LSTM研究. 而2025年底迎来了一个巨大的飞跃: 一个名为OmniPredict的系统,采用多模态大语言模型,成为首个实时预测人类行人行为的模型,脱颖而出. 车辆正在逐渐学会你脑海中那种快速的直觉.
让车辆有"表情": eHMI实验真的管用吗?
过去,驾驶员和行人靠手势、面部表情等非正式线索来沟通. 自动驾驶汽车开发者也试图把这些线索搬到机器上,于是开始了外部通信界面,即eHMI的实验. 在最早的重要实验之一中,一辆代表自动驾驶汽车的房车向行人展示了何时可以过街的信息; 随后又尝试了屏幕、光带,甚至安装在车顶上的机器人眼睛.
机器眼睛的实地研究结果颇为混杂——而我认为恰恰因此才显得有价值. 注意到这些眼睛的人安全感有所提升,另一项独立的360°视频实验表明,这些眼睛有可能减少潜在的交通事故. 但同样的参与者却认为这些眼睛"并非必要". 也就是说,可爱的车脸讨人喜欢,但并非必需. 行业方面也表达了类似的看法: 为了让行人感到安心,车辆需要以人类能自然理解的方式表达其行为,而发表在Science上的一项分析强调,路口的行人期待来自车辆的确认,即它"看到"了自己.
不过这里存在一个奇怪的悖论,不容忽视: 无论你把沟通设计改进到什么程度,都可能无法阻止用户的风险行为. 一项针对儿童行人的研究表明,即使自动驾驶车辆在远离路口处亮起绿灯并减速,儿童仍然会表现出更具风险的过街行为. 也就是说,在屏幕上写"你可以通行",并不能阻止一个孩子说"那我跑过去吧". 无论技术多么先进,人为因素仍然是最多变的一环.
为什么事故总是恰好发生在这种互动瞬间?
现在让我们进入残酷的部分. 行人-自动驾驶汽车互动安全模型计算出的预期碰撞次数为每百万车辆公里 4 至 5.5 起——而且这一数值被明确认定为令人担忧的风险水平. 更何况,传统行人事故的根源也同样存在于这一区域: 行人事故中约有一半发生在远离过街设施的地方,多数是在停放的车辆旁边. 也就是说,问题主要不是在"车辆看不见我"的时刻爆发,而是在车辆不得不与我进行"讨价还价"的时刻爆发.
有些行人类型会让算法也感到棘手: 搬运大件物品、遛狗或穿着奇装异服的行人,可能会延迟或迷惑检测系统. 部分遮挡、人群密集场景以及模糊的线索,也属于难点所在. 2018 年在亚利桑那州发生的首起由自动驾驶汽车导致的行人死亡事故,正是发生在这样一种场景中: 行人当时所处的位置,是车辆根本来不及刹停的距离. 这一领域还有一项早期关于检测偏见的研究也令人铭记; 深色皮肤行人更难被识别的说法在当时引发了争议,而这一话题至今仍是一个需要严肃对待的问题.
透明度鸿沟: 谁在共享数据,谁不在共享?
行业中另一种紧张关系在于安全数据的共享. Waymo发布了研究,显示其车辆比人类驾驶安全五倍,在与行人的交互中安全十二倍,并自愿公开安全数据. 另一方面,在一项行业批评之后,Tesla 停止发布详细的安全数据. 同一个市场中,一方在倾倒数据,另一方却在拉上帷幕——这让公众手中无法获得公平比较的机会.
在认知层面还有一个有趣的偏差: 即使自动驾驶汽车并非更有缺陷,人们仍然比人类驾驶员更多地指责它们. 也就是说,机器的错误不可原谅,而人的错误却被视为平常. 公众认知与数据之间的这道鸿沟,宽到足以遮蔽这项技术真正的成就.
那么,自动驾驶汽车最终是如何与行人"达成默契"的呢?
这正是我承诺给你的明确答案: 自动驾驶汽车与行人的沟通靠的不是眼神接触,而是 行为解读. 传感器持续跟踪行人,人工智能将速度、位置、视线和情境综合起来预测其意图; 必要时,eHMI 屏幕或车辆行为——明确的减速、明确的停车——将信息传递给外界. 新"协议"的语言不是旧日的对视,而是动作与情境. 你用你的步态告诉它你的意图,而它用刹车声向你说明它的决定.
我的总结是: 机器端的预测每年都在变得更好,但互动仍然是一场双方参与的游戏. 如果缺乏数据共享上的透明、eHMI设计上的谦逊,以及我们用户再多一点的耐心,这笔交易就不算完整. 如果是您,您会相信那双眼睛,还是会相信刹车声? 我倾向于后者——不过那双机器人眼睛的可爱劲儿也功不可没.
参考资料
- Pedestrian Crossing Intent Prediction via Psychological Features and Transformer Fusion
- Pedestrian Intention Prediction for Autonomous Vehicles
- Pedestrian Intention Prediction Using LSTM for Right-of-Way
- Eye Contact Between Pedestrians and Drivers
- Safe Crossings: The Power of Eye Contact
- External Human–Machine Interfaces for Autonomous Vehicles
- Evaluation of Vehicle-to-Pedestrian Communication Displays
- A Field Study on Pedestrians' Thoughts toward a Car with Eyes
- Can AI read humans' minds? A pedestrian behavior model
- Waymo Safety Impact